2.2 结构生成模式
本节将重点介绍StrucEluc 系统的核心工作模式。该系统目前可解析分子量高达1,500原子质量单位、含100 多个骨架原子的复杂分子结构,其标准设计解析能力更可扩展至含250 个骨架原子的分子体系。该技术主要基于二维核磁共振谱图数据分析实现,其作为复杂分子(特别是天然产物)结构解析工具的卓越性能,已通过大量研究文献[8-12](包括综述[11,13]及专著[14])获得充分验证。
需要强调的是,许多问题仅需分子式、异核(HSQC/HMQC、HMBC 或COLOC)和同核(H–H COSY)2D NMR 相关性数据即可解决,而无需其他结构信息。在这种称为通用模式(Common Mode)的操作中,系统从光谱数据中创建连接性,并根据默认设置生成所有可能的结构。默认设置包括骨架原子之间的键数、原子性质(如杂化状态)以及考虑相邻杂原子的可能性。
然而,某些问题由于2D NMR 数据信息不足而无法解决或耗时过长(例如参见第4.34节)。在这些情况下,引入额外的结构信息(如果可用)被证明是必要的,以促进解析过程。在实际应用中,化学家或光谱学家在解析结构时通常会对合成反应组分、可能分离出的化合物类别甚至假设结构有一定的先验知识,而不是完全从零开始解析。
研究表明[14],利用系统知识库中的分子片段或化学家提出的潜在子结构可以有效规避这些困难。这种片段方法已被用于许多第一代专家系统中,这些系统基于包含子结构及其特定光谱特征相关特征区间的关联表。相比之下,StrucEluc 使用包含子结构及其相关13C NMR子光谱的数据库。目前,StrucEluc 数据库包含超过290,000 种化学结构和超过200 万个子结构。随着更多文献数据的添加,数据库继续增长。将子结构直接纳入解析过程的价值在于,被视为宏原子的片段可以吸收大量骨架原子,从而降低问题的复杂性。这加速了结构生成过程,而结构生成通常是结构解析过程中最耗时的阶段。
然而,当使用2D NMR 数据时,分子片段的应用受到一定限制:用于解决问题的片段中所有碳原子必须提供化学位移值,且这些化学位移值应尽可能接近未知物实验13C NMR谱中相应片段原子的观测值。具体而言,碳原子的近似化学位移值可通过ACD/C NMR Predictor 获得。在结构生成之前,需将片段碳原子的近似化学位移值替换为最接近的实验观测值。这一要求的原因显而易见:使用2D NMR 相关性时,只能基于实验观测的化学位移值。
将片段整合到从2D NMR 数据导出的连接性集合中,是一个需要开发新算法的问题。本章将探讨StrucEluc 系统的多种应用策略。根据可用的初始数据和分析分子的复杂性,系统提供了多种解决问题的方法。这些方法能够帮助用户根据具体需求选择最适合的解析路径,从而提高结构解析的效率和准确性。
2.2.1 “通用” 2D NMR 模式
StrucEluc 系统基于一系列程序,旨在通过多种2D NMR 光谱协同解析分子结构。最常见的组合包括H–H COSY、HSQC/HMQC 和HMBC,这些数据为结构确定提供了基础。此外,系统还支持其他2D NMR 方法,如ROESY、NOESY、TOCSY、ADEQUATE 和INADEQUATE [15]。系统通过灵活的流程允许用户输入和处理实验2D NMR 数据,从而适应多种实验方法。
在结构生成之前,系统会检查MCD 是否存在矛盾(参见第2.1.4 节)。连接性表中收集的数据以MCD 形式图形化呈现,并作为2D 结构生成器的输入信息。如果MCD 检查显示2D NMR 数据一致,则启动严格结构生成(Strict Structure Generation)。结构生成在分子式、MCD 以及化学家可能引入的额外约束条件下进行。结构生成器基于Molodtsov 开发的数学算法,并在Structure Elucidation 程序开发过程中进行了优化[6, 14]。
通常,结构生成通过执行命令Structure Elucidation/Run CSB Generator(CSB,Correlation Spectroscopy Based)启动。执行此命令后,系统将依次从所有现有MCD 中生成结构。命令Structure Elucidation/Run SCB Generator from Current MCD 允许从化学家选择的单个MCD 中生成结构。图2.10 展示了与CSB 生成器选项相关的对话框窗口。
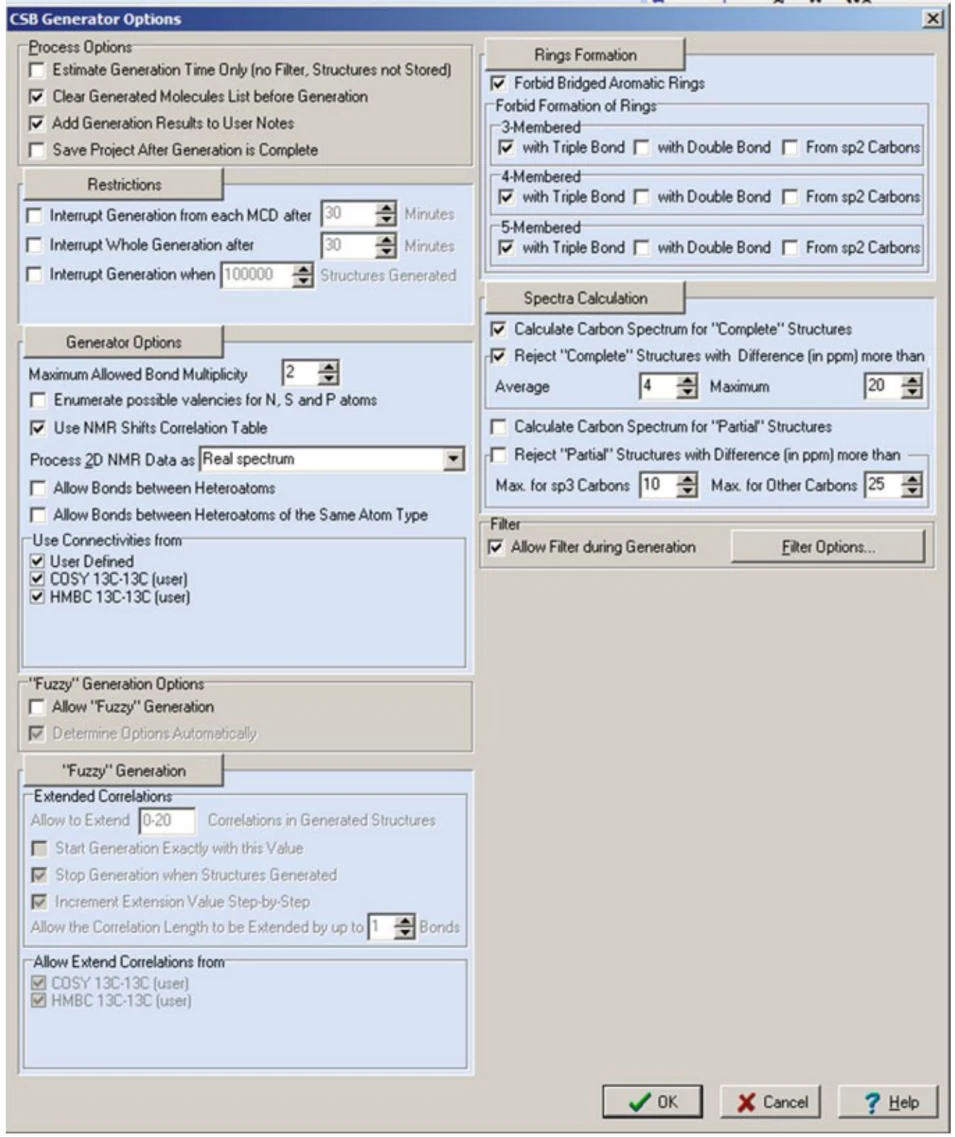
大多数选项的含义直观易懂,但部分选项需要进一步说明。Estimate Generation Time Only(仅预估生成时间)选项在初始数据不确定且需要预估生成时间和生成结构数量时选择。当结构生成预计耗时较长(例如程序需要整夜运行)时,建议选择Add Generation Results to User Notes(将生成结果添加至用户注释)和Save Project After Generation is Completed(完成后自动保存项目)选项。
一组名为Use Connectivities from 的选项允许化学家在结构生成过程中使用不同组合的2D NMR 光谱。例如,如果COSY 数据中存在3-5 个长度为4J 的非标准连接性,可能会显著延长模糊结构生成(FSG)的时间。在这种情况下,取消勾选COSY 复选框并仅基于HMBC数据进行结构生成可能更为高效。
Spectra Calculation 和Allow Filtering during Generation 选项通常结合使用,在结构解析过程中起到关键作用。这些选项的目的是排除那些预测化学位移与实验值差异过大的生成结构。在光谱过滤层面,通过特征光谱区间实现粗略的谱图预测。如果生成结构中至少有一个13C 或1H NMR 化学位移不符合相应的光谱区间,该结构将被过滤器排除。由于无法完全考虑分子中给定原子所有可能的环境对其化学位移的影响,过滤器有时可能会错误地排除正确的结构。因此,为了最小化正确结构丢失的风险,可以使用Spectrum Calculation 选项。为此,需选择命令Calculate Carbon Spectrum for Complete Structures 和Reject Complete Structures with Difference (in ppm) more than,并指定平均偏差和最大偏差作为当前结构排除的阈值。13C 化学位移预测采用增量法(Incremental approach)实现,计算速度高达每秒30,000 个化学位移。在实际操作中,几乎无法察觉13C 化学位移计算是否在结构生成过程中被使用。经验表明,将阈值设置为d = 4–5 ppm 和dmax = 20–25 ppm 是优化输出结构文件大小的理想值。当启用Spectrum Calculation 选项时,在Filter Options 对话框中,Carbon Assignment 复选框会自动选中,并且Maximum Match Factor 和Maximum Shift Difference字段会自动填充,如图2.11 所示。
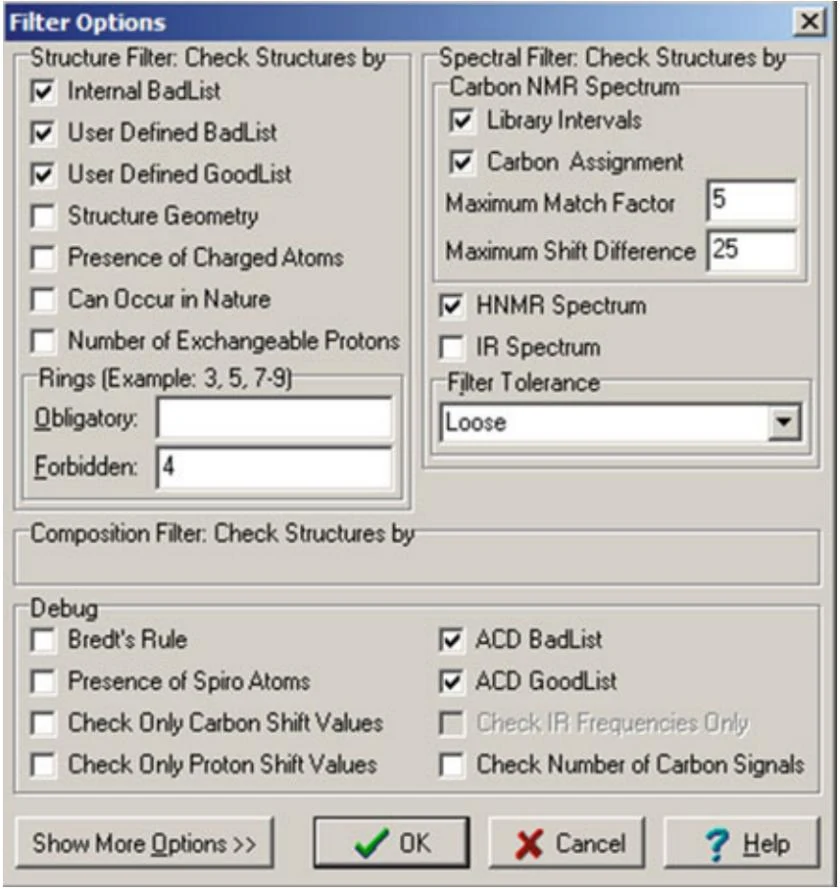
当启用13CNMR 谱图计算时,过滤器可以发挥双重作用:一方面,它可以根据计算的
13C NMR 化学位移对结构进行筛选;另一方面,它也可以作为独立的光谱和结构过滤器使用。如果过滤器仅用于13C 化学位移计算,则需要取消勾选Library Intervals 和HNMR Spectrum 复选框,同时可以应用对话框左侧显示的所有结构约束条件。如果过滤器在Spectrum Calculation 禁用模式下运行,则需确保Carbon Assignment 选项也被取消勾选,否则过滤器将排除所有结构,因为它们缺乏可供比较的偏差值。如果同时启用Spectrum Calculation 和光谱过滤(勾选Library Intervals 和HNMR Spectrum 复选框),输出结构文件的规模将显著缩小。
这里引发了一个问题:哪种方法能够更有效地减少输出结构文件并排除无效结构?我们认为,传统专家系统的操作流程“片段选择→结构生成→结构光谱过滤”可以进行优化调整。具体而言,可以用Spectrum Calculation 替代结构光谱过滤,并仅使用光谱过滤来排除不满足阈值条件(d < 4–5 和dmax < 20–25 ppm)的结构。最终,只有通过这一筛选阶段的结构才会被保存。在此过程中,通过13C 和1H NMR 特征光谱区间对结构进行验证,可以作为辅助手段进一步确保结果的可靠性。
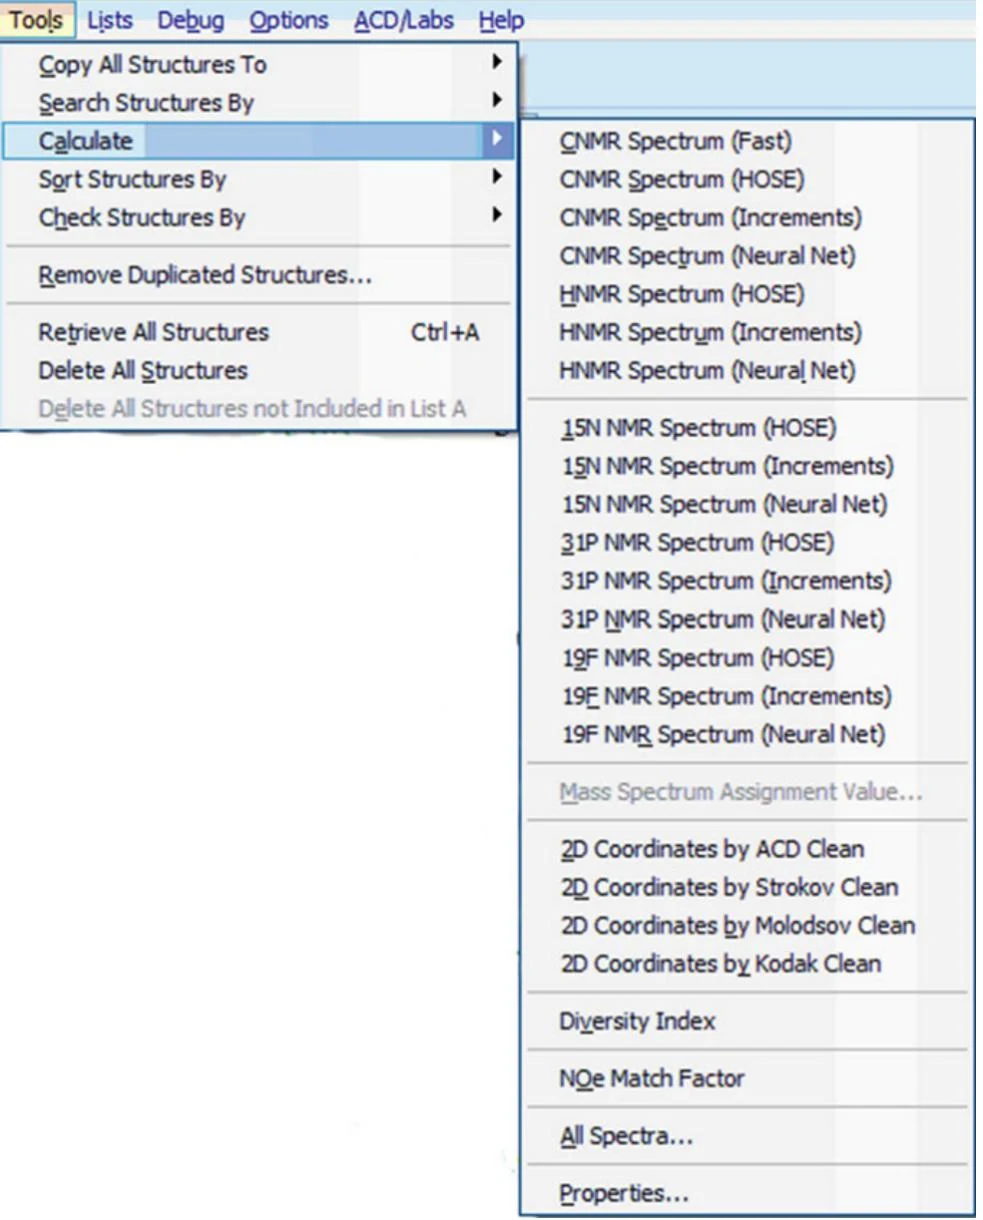
用户可以通过点击程序主窗口工具栏中的MOL 键查看生成的结构。系统将对输出文件中的所有结构进行13C NMR 谱图预测,并按照d 值递增的顺序对结构进行排序(排序方法将在下一节详细介绍)。如需执行NMR 谱图计算,用户可点击工具栏中的Tools 键,并从下拉菜单中选择需要预测的谱图类型(图2.12)。
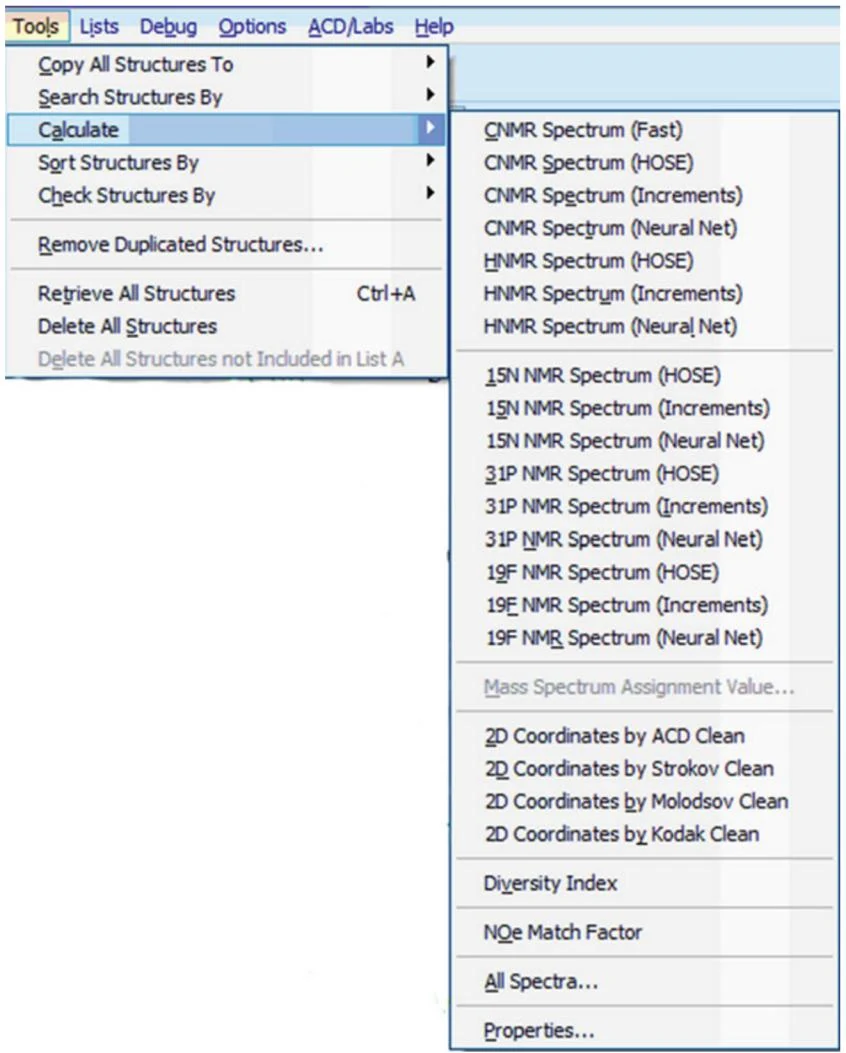
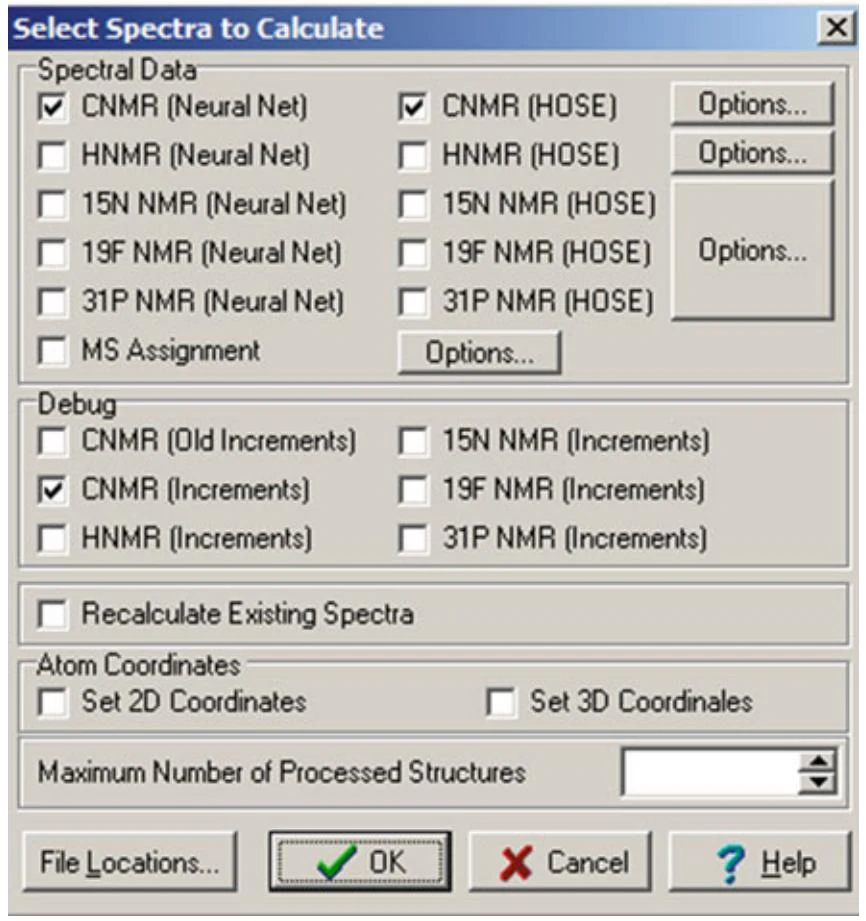
如果用户希望通过不同的谱图计算方法预测多种NMR 谱的化学位移,可以激活命令All Spectra…。在弹出的Select Spectra to Calculate 对话框(图2.13)中,用户可以通过勾选复选框选择相应的谱图。默认情况下,系统会对给定结构文件中的所有结构进行化学位移计算,但用户也可以指定Maximum Number of Processed Structures 以限制处理的结构数量。
如果用户有自己的结构假设,可以在PM(Proposed Molecule)窗口中绘制所提出的结构,并通过工具Edit Atom Properties 进行13C 和1H 化学位移归属。随后,系统可以使用所有可用的二维NMR 谱图对提出的结构及其相关的13C 和1H NMR 信号归属进行验证。为此,用户需激活命令Structure/Check by 2D NMR Data (1)。如果发现任何非标准连接性,程序将显示一条文本消息,详细说明冲突的原因。同时,所有连接性将以图形形式显示在结构上。为了便于视觉分析,非标准连接性会用红色标记。
2.2.1.1 最优结构的筛选流程如前所述,最优结构的选择通常简化为对输出文件中各结构的NMR 化学位移预测,并按偏差值升序进行结构排序。作为结构解析的核心环节,本系统采用三级验证机制从输出文件中筛选最优候选结构,具体流程如下:
步骤一:初步谱图预测与偏差计算使用增量法(Incremental method)对所有生成结构进行快速13C NMR 谱预测,计算实验谱与预测谱的平均偏差值(dI)。若结构生成阶段已启用13CNMR 化学位移计算,本步骤自动跳过。
步骤二:冗余结构清除与优先排序删除输出文件中的重复结构(Tools\Remove Duplicate Structures…,图2.12)。在生成的结构中,通常存在仅化学位移归属不同的重复结构。如果在删除同构结构时未充分考虑这一点,可能会导致具有正确化学位移归属的结构被删除。为避免这种情况,系统执行了专门的重复结构删除程序。对于每个重复家族,仅保留dI 值最小的结构作为家族的“最佳代表”。删除重复结构后,系统按dI 值对结构进行排序(Tools\Sort Structures by\C NMR Spectrum(Increments),图2.12)。dI 值越小,表明实验谱图与计算谱图的匹配度越高,因此该结构将排在列表的最前面。经验表明,正确结构通常位于排序列表前五位,极少数情况下会出现在第五位之后。此步骤可高效排除90% 以上的无效候选结构。
步骤三:采用神经网络算法验证使用神经网络(NN)算法进行13CNMR 化学位移预测,并再次按偏差值dN 对结构文件进行排序。如果结果文件非常大,可以仅对前几千个结构进行计算(耗时仅几秒)。通过此步骤,可以更可靠地选择优选结构。
若初始结构文件规模适中,建议在完成dI(增量法偏差)和dN(神经网络算法偏差)值计算后再执行重复结构删除操作。通过增量法与神经网络算法的交叉验证,当两种方法共同筛选出相同的最佳结构时,可显著提高获得正确结构及其化学位移归属的可靠性。
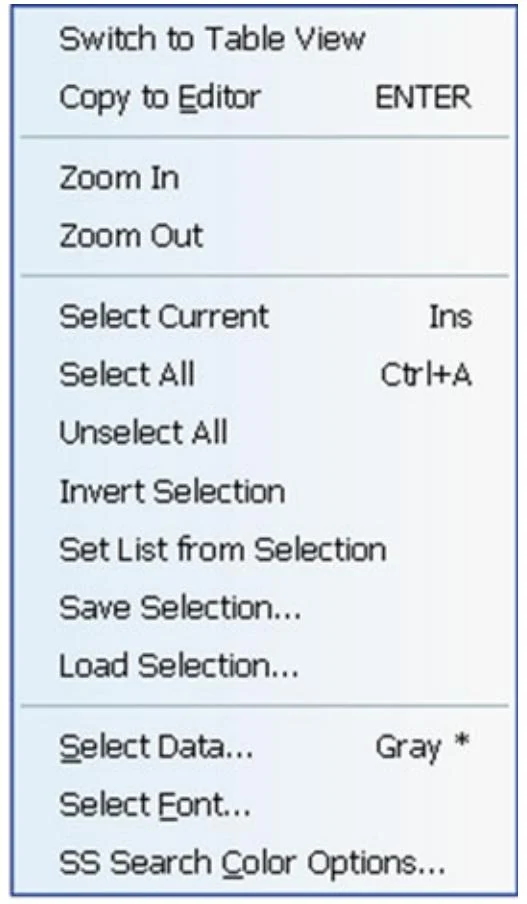
用户可通过点击工具栏中的Display Structure and Tile 图标,以Tile 模式查看排序后的结构文件。在结构列表显示区域单击右键(图2.14),将弹出包含直观功能选项的菜单,便于用户对Tile 模式下显示的结构信息进行管理。
步骤四:精细化验证在此阶段,通常对排序文件中前10-50 个(特殊情况下可达100 个)结构,采用基于HOSE 算法进行13C NMR 谱图预测(耗时约数分钟)。计算实验值与预测值的平均偏差(dA),并据此重新排序。通过连续排序,正确结构出现在列表首位的概率显著提高。
为进一步确保输出结构选择的准确性,可基于HOSE 算法预测氢谱化学位移,并同步显示对应的偏差值dH。同时,可使用复合匹配因子dcomplex=dN(C)+10dN(H) 对输出文件中的结构进行最终排序验证。
正确结构在文件中的排名位置取决于排序参数类型(如dN、dA、dI、dH 或dcomplex)。正确结构在排序文件中的"排名率"分别用rN、rA、rI 和rH 表示。若某结构按dA 值排序位列第一,则rA=1。通常最终结构排序基于dA 和dN 值的升序排列,而dI 和dH 参数作为辅助指标评估结构选择的可靠性。
点击工具栏Show\Hide Carbon Assignment 按钮,可通过原子标记的彩色圆圈可视化评估各碳原子的化学位移预测精度:
绿色:实验值与预测值差异Δ ≤3 ppm黄色:3 ppm < Δ ≤15 ppm红色:Δ > 15 ppm
通过工具栏图标和可查看以下信息:
第一个图标显示实验与预测的1H、13C、15N NMR 化学位移及原子编号(图2.15 左)
第二个图标展示用户选择的连接性类型(图2.15 右)
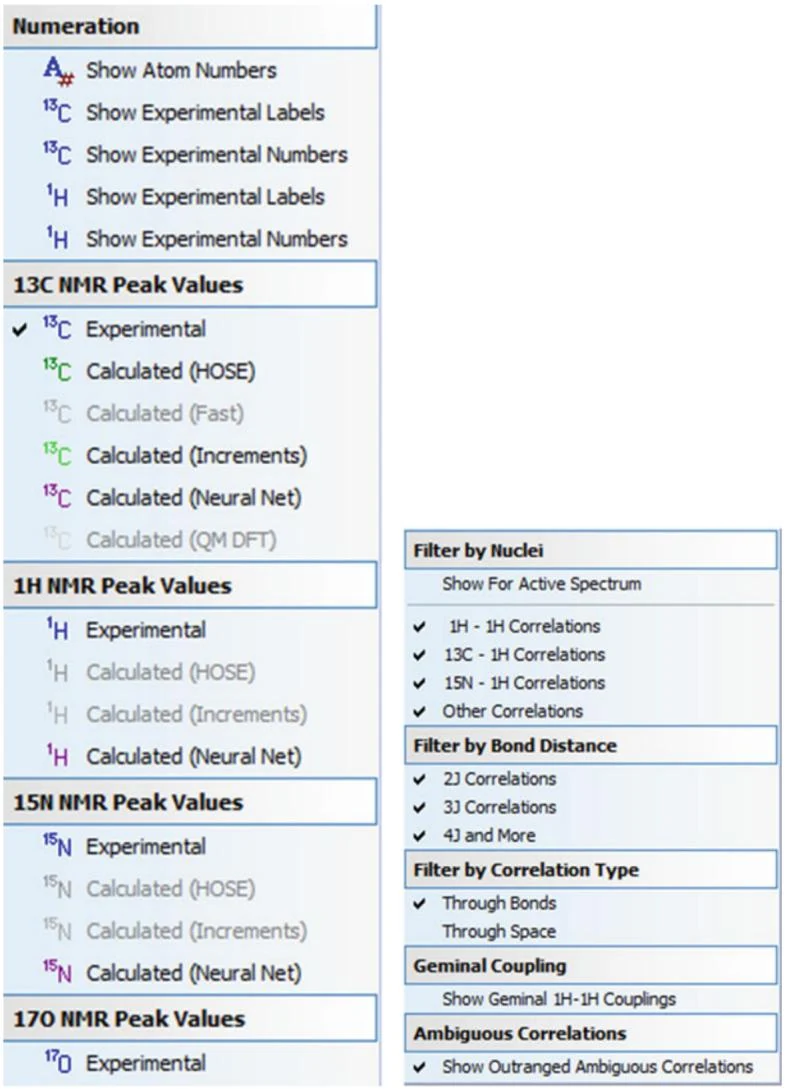
右侧展示了不同来源和不同长度的连接性。
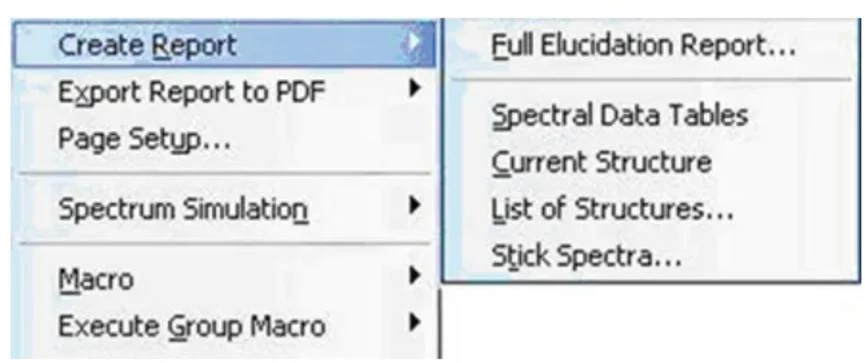
通过File\Create Report\List of Structures(图2.16),可将Tile 模式显示的首选或选定结构复制至ChemSketch 窗口。
当排名前两位结构存在显著差异时,可激活质谱归属值命令(图2.12)计算MS 匹配因子mi(i 为结构在排序文件中的位置)。该功能通过计算实验质谱峰与理论裂解模式的匹配百分比实现,由于耗时较长,建议仅在dA 差值Δ(2−1) = dA(2) - dA(1) 较小时使用(dA(1)、dA(2)分别为第一、二位的偏差值)。
在复杂或不确定的情况下,以图形形式展示计算的1H NMR 谱图可能有助于进一步分析。此外,为了便于对输出文件中的结构进行分析,StrucEluc 系统提供了计算结构相似性系数的功能(Structure →Similarity Search in →Generated Molecules)。如果研究者对目标化合物的类别有一定了解,可以将已知结构作为输入,从而根据结构相似性对结果文件中的结构进行排序。
当最优结构确定后,研究者可能会提出以下问题:如果实验光谱中观测到所有理论上可能的HMBC 和/或COSY 相关信号(2D NMR 光谱类型由用户选择),会生成哪些结构?为回答这一问题,可以使用命令Structure →Create Project from Structure。程序将创建一个新项目,其中MCD 包含所有理论上可能的连接信号,从而基于这些连接信号进行结构生成。这一功能能够帮助研究者全面评估理论相关性对结构生成的影响,为结构解析提供更全面的视角。
2.2.2 分子片段与2D NMR 数据的结合应用
基于2D NMR 数据的计算机辅助结构解析(CASE)技术,在复杂有机分子结构鉴定中展现出显著效率。然而,当MCD 的结构限制无法在合理时间内生成足够数量的候选结构时,引入分子片段可有效突破这一瓶颈。这些片段通常可从Structure Elucidator 知识库中获取,其核心优势在于:每个片段的碳原子均携带来自完整分子结构的13C NMR 化学位移信息,而这些数据直接来源于构建片段库时所用的原始结构数据库。
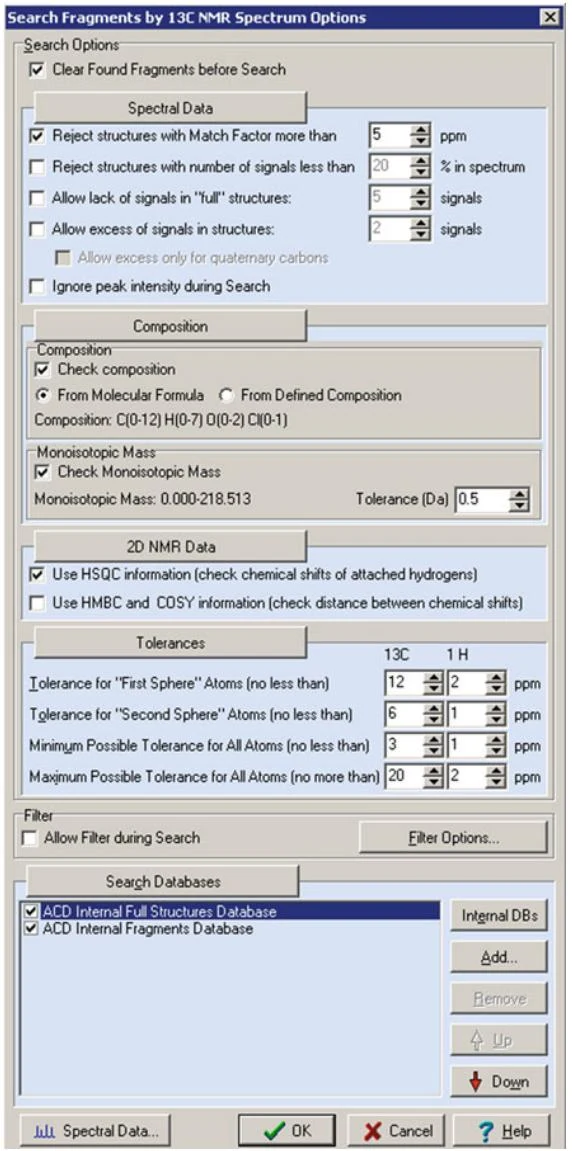
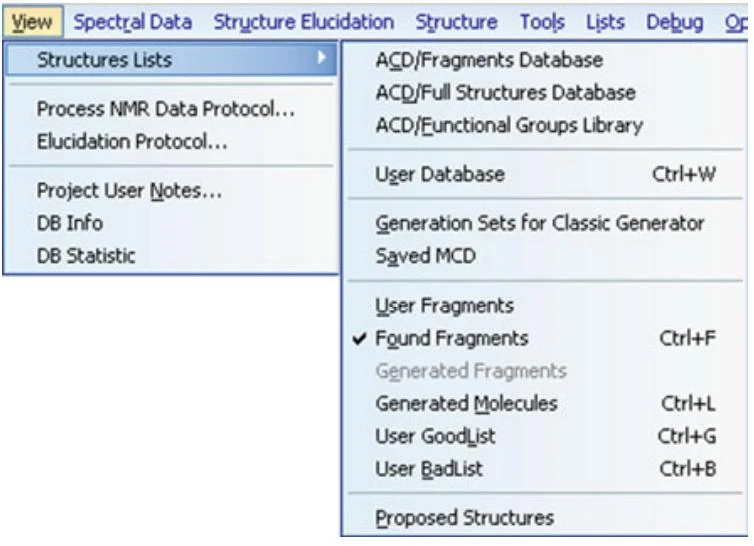
流程的第一步是通过命令Structure Elucidation\Search Fragments by C NMR Spectrum(图2.17)启动片段库的片段搜索。研究人员可通过Search Fragments by 13C NMR Spectrum Options 对话框(图2.17)调整默认参数。例如,勾选From Molecular Formula选项后,所有找到的片段分子式均不会超出目标分子式的组成范围。用户还可选择性启用Utilization of 2D NMR connectivities (利用2D NMR 连接性)和usage of the filter(过滤器)功能,以提升搜索精度。完成搜索后,结果将显示于Found Fragment 窗口(View\Structures List\Found Fragments,见图2.18)。
完成片段搜索后,系统将筛选出L 个Found Fragments。随后需基于这些片段(FF)构建MCD,具体操作为:Structure Elucidation\Create MCDs Using Fragments(参见图2.6),此时将弹出Create MCDs Options 对话框(图2.19)。首次运行时,建议采用自动选项配置以简化流程。
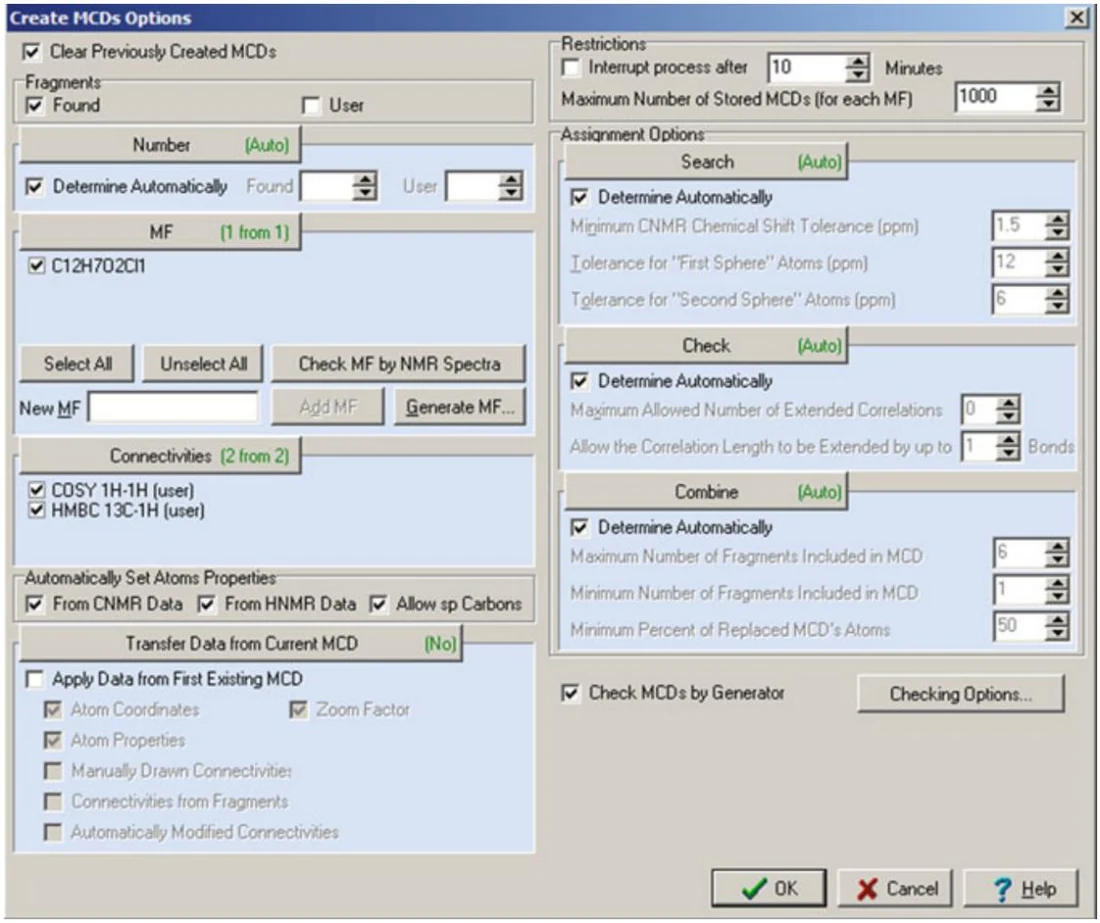
MCD 创建与片段筛选机制在MCD 创建过程中,FF(Found Fragments)的数量可由用户手动设定或由程序自动确定。该算法的核心逻辑围绕两个关键参数展开:化学家需预先定义用于构建MCD 的片段数量上限l(l ≤L),并设定误差阈值E,即允许的片段碳原子理论化学位移与实验谱观测值之间的最大绝对差值。需要强调的是,l 与E 存在紧密关联性,最优参数组合通常需通过试错调整确定。
程序将每个片段的13C NMR 子谱与所有实验化学位移进行比对。在此过程中,碳原子连接的氢原子数目会被纳入考量。假设某片段包含n 个碳原子,其中任意碳原子Ci 的化学位移为δi(i = 1÷n),多重性为mi。若实验谱中存在满足条件|δi – δiq| ≤E 且mi = miq 的化学位移值δi1, δi2, … δiq, … δip,则需验证用这些实验值替换δi 的所有可能性。
当所有f 个碳原子均满足|δi – δiq| ≤E 和mi = miq 的条件时,该片段将被视为候选片段并用于MCD 创建。若任一条件不满足,则该片段被排除。程序还会检查片段碳原子归属是否与实验化学位移相关性(基于片段骨架原子组成)一致。通过验证的片段将被归入候选片段集合。
片段覆盖的骨架原子越多,结构解析过程耗时越短。为此,程序开发了一种将候选片段组合至同一MCD 的算法:遍历所有候选片段的可能组合,仅选择与实验2D NMR 相关性数据匹配的组合,形成候选片段组合集。这些片段与剩余的自由原子共同映射到MCD 中,供用户进行可视化分析。
MCDs 的总数(nMCD)取决于用户定义的以下参数:
L:用于创建MCD 的Found Fragments 数量(需满足l ≤L);
nf:每个MCD 中必须包含的最小片段数量;
q:每个MCD 中所有片段必须覆盖的骨架原子最小百分比。
一般而言,MCD 中片段覆盖的原子数量越多,基于该MCD 生成分子结构的效率通常越高。结构生成速度与组成MCD 的分子片段尺寸密切相关:若MCD 由大量小片段构成,生成速度会显著提升;而当MCD 包含少量大片段时,生成速度同样加快。根据待分析分子的尺寸以及FF 排序列表中片段的初始大小,nf 值通常设定为1 至4 之间的整数,q 值的最佳效率区间为40%-60%。
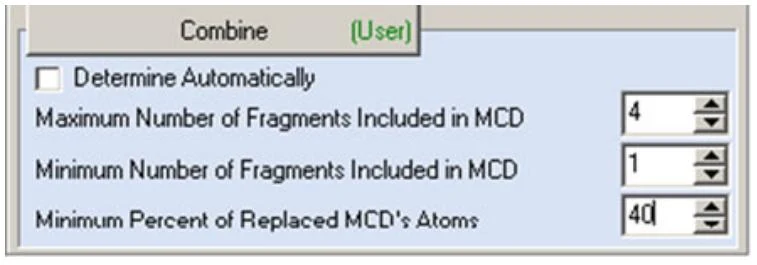
图2.20所示的对话框用于设置创建MCD时允许包含的片段数量范围(最小值和最大值)。通过合理配置这些参数,用户可在结构解析效率与计算资源消耗之间实现平衡优化。
完成全部验证步骤后,程序将对所有生成的MCD 进行矛盾性检查,并提供选项自动删除存在逻辑矛盾的MCD。通过校验的MCD 可直接用于结构生成流程。用户可选择跳过连接性验证阶段(因矛盾MCD 在结构生成时会被自动识别并剔除),也可基于先验知识(如已知结构类型或目标分子特征)手动筛选特定MCD 进行优先处理。为降低选择复杂度,系统会按游离碳原子数量升序自动排列MCD 列表,推荐从首位开始依次选用。
当片段集生成的MCD 数量过大(例如nMCD>1000)时,程序提供批量属性同步功能:通过执行MCD\Apply Properties to All MCDs 命令,可将首个MCD 中修改的原子坐标、缩放比例、原子属性、手动连接关系,以及矛盾检查中自动修正的连接模式,一键应用于全部MCD。该机制大幅提升了基于先验知识的片段式解析效率,尤其适用于同系物或结构类似物的快速分析。
在解析全新化合物的时候,若数据库片段(found fragment,FF)无法有效降低解析复杂度,可引入用户自定义片段(user fragment,UF)辅助构建MCD。UF 与FF 的核心区别在于:FF 的碳原子已绑定实验化学位移数据,而UF 的碳化学位移处于未定义状态。程序支持两种UF 导入模式:
采用HOSE 算法(详见第1.4.1.1 节)计算用户片段的碳原子化学位移;
在知识库中搜索包含该用户片段的结构单元。
通过上述两种途径,程序通常至少能从其中一种来源获取可用片段。
2.2.2.1 E 值的选择策略在基于片段创建MCD 的过程中,E 值(化学位移允许误差阈值)的选择至关重要,因为它直接影响片段应用的效果。E 值的设定遵循以下原则:通常情况下,E 值越小,由FF生成的MCD 数量(nMCD)越少,这有助于缩短结构生成时间(tg)。然而,tg 也受到片段尺寸的影响——较大的片段通常能加速结构生成,但如果片段过大且包含大量已归属碳原子(尤其是终端原子),其化学位移可能难以满足严格的±E 区间要求。为此,程序自动将终端原子的E 值设为12 ppm(图2.21)。
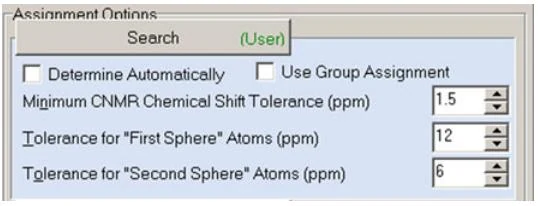
学位移容差E 设为1.5 ppm。
大片段在结构解析中具有显著优势,但为了充分发挥其作用,通常需要设置较大的E值。然而,较大的E 值会显著增加nMCD 值。因此,最优策略是设置足够大的E 值,并仅选择包含大片段的MCD 用于结构生成。这一原则支持手动或自动排除包含小片段的MCD。实验表明,用于创建MCD 的片段最小碳原子数应设置为5,这一参数配置可显著提升解析效率。
由于无法确定一个适用于所有问题的最优E 值,因此建议针对每个任务进行动态优化。具体操作是从1.5 ppm 开始逐步增加E 值,该过程可在结构生成阶段手动或自动完成。通过这种渐进式调整,用户能够在化学位移匹配精度与结构生成效率之间找到最佳平衡点。