2.1 数据输入、处理与分子连接图的构建
我们假设读者已具备扎实的NMR 光谱解析能力,能够熟练运用传统方法处理原始的一维和二维NMR 数据,包括标峰、基于光谱特征的结构解析等。这些能力在计算机辅助结构解析(CASE)的各个阶段都不可或缺,尤其是在为计算机输入光谱数据的准备阶段。这一阶段至关重要,因为它为后续的结构解析奠定了“公理”与假设的基础(参见1.2 节)。需要特别指出的是,尽管CASE 系统能够自动生成结构解析所需的大部分公理与假设,但其最终确认仍需化学家完成。化学家的专业知识与经验在这一过程中依然发挥着不可替代的作用。
此外,我们还假设化学家具备质谱解析的知识与经验。能够准确分析分子离子峰簇并从精确分子质量推导出分子式,这是高效使用CASE 系统的关键能力。因此,本章将简要介绍初始NMR 光谱数据预处理的主要步骤,并演示如何利用Structure Elucidator 的功能与界面将数据输入程序。为此,我们将以一个典型示例为基础,该示例中的一维和二维光谱质量良好,且待解析分子为常见复杂度的天然产物。
在本教材第三部分的示例中,我们将使用已处理并保存为电子表格的NMR 数据,其格式与Structure Elucidator 兼容。重点将放在如何克服初始数据中的不确定性、不完整性和矛盾性上,并详细解释Structure Elucidator 为此提供的不同操作模式。通过这一过程,读者将能够更深入地理解如何在实际应用中灵活运用CASE 系统,以高效完成复杂化合物的结构解析任务。
2.1.1 用于结构解析的数据类型
在计算机辅助结构解析(CASE)中,多种类型的数据可用于支持分析。正如前文所述,二维核磁共振(2D NMR)是解析复杂化学结构的关键技术。然而,由于其数据处理和操作的复杂性,这类NMR 对软件提出了更高的要求。2D NMR 结构生成器需要输入一组原子及其之间的连接关系,同时还需考虑这些原子的化学位移以及一系列结构约束条件。
原子的基础集合通常从分子式中获取,而原子之间的连接关系则通过结合一维和二维NMR 光谱数据来揭示。以下是结构解析中常用的光谱类型:
质谱(Mass Spectra)
质谱主要提供化合物的分子质量和元素组成(结合NMR 和红外光谱数据),从而为待测化合物推导出分子式。值得注意的是,分子式的确定对于手动或使用专家系统进行结构解析都至关重要。质谱中的碎片信息还能进一步揭示化合物中关键分子片段的存在,为分子组成提供更多细节。
一维NMR 光谱(1D NMR Spectra)
一维核磁共振谱(1D NMR)能够提供分子结构中各原子的电子环境信息,包括:1)原子间的骨架连接关系;2)空间邻近效应;3)分子内旋转能垒等结构特征。这些信息通过化学位移、耦合常数和峰形等参数得以体现。
二维NMR 光谱(2D NMR Spectra)
二维核磁共振谱(2D NMR)则能同时揭示原子间通过化学键(J 耦合)和空间(NOE效应)的相互作用信息。当多种类型的2D NMR 谱(如HSQC、HMBC、NOESY 等)被同时采集和分析时,其提供的信息最为丰富和可靠。
数据准备:结构解析的关键步骤无论是手动还是自动化结构解析,数据准备都是至关重要的环节。在这一过程中,几乎任何错误都可能导致最终解析出的结构出现偏差。因此,在将数据输入Structure Elucidator之前,必须尽可能仔细地进行数据准备。数据准备主要包括两个关键步骤:原子列表的确定和原子间连接关系的确定。
虽然结构生成算法能够自动修正原子间连接关系中的不一致性和部分错误,但对于原子列表中的错误却几乎无法纠正。因此,确保原子列表的准确性是数据准备中的首要任务。
在数据准备过程中,化学家需要通过“Spectrum Parameters”对话框指定与光谱记录相关的主要谱仪参数。
此外,化学家还可以为F1 和F2 轴设定化学位移的用户定义容差值(User Defined Tolerance,单位为ppm)。这些参数会显著影响问题的复杂性(如输出文件的大小、结构生成的时间等),因此需要谨慎设置。
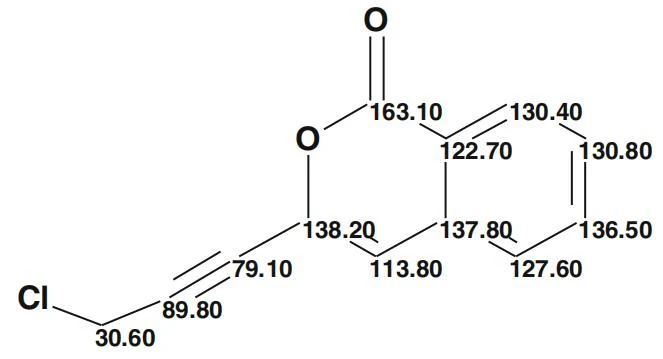
本章所述的大多数操作流程将以小分子化合物gymnopalyne [1]作为示例进行演示。该化合物分子式为C12H7O2Cl,其结构特征在于含有多种杂原子以及具有不同化学环境的碳原子。下文展示了gymnopalyne 的结构式(2.1),其中各碳原子的13C 化学位移值已进行明确归属。
2.1.2 分子式确定
结构生成算法需要以原子列表作为初始输入数据,而分子式(MF)作为该列表的简洁表示形式,是进行结构解析的必要前提条件。通常,单同位素精确质量数可通过分析质谱图中分子离子峰(m/z)来确定。但需注意的是,分子离子峰并非总是存在于质谱图中——这种现象在电子轰击电离(EI)谱中较为常见,而采用更"温和"的电离方法(如电喷雾电离)获得的质谱通常能检测到分子离子峰。
采用电喷雾正离子模式(ESI+)获得的质谱图中,主要存在质子化分子离子峰[M+H]+,此外还可能包含其他加合离子峰,如[M+Na]+、[M+K]+和[M+NH4]+等。在推算分子式时,必须对这些加合离子信息进行校正处理,即对单同位素质量数进行相应调整。
Structure Elucidator 内置了分子式生成器(Molecular Formula Generator),该工具能够根据给定的分子质量和设定的质量容差值(tolm)生成所有可能的分子式。要使用分子式生成器,首先需要激活命令Structure Elucidation/Create Molecular Connectivity Diagram,随后将弹出“Create MCDs Options”对话框(图2.1)。
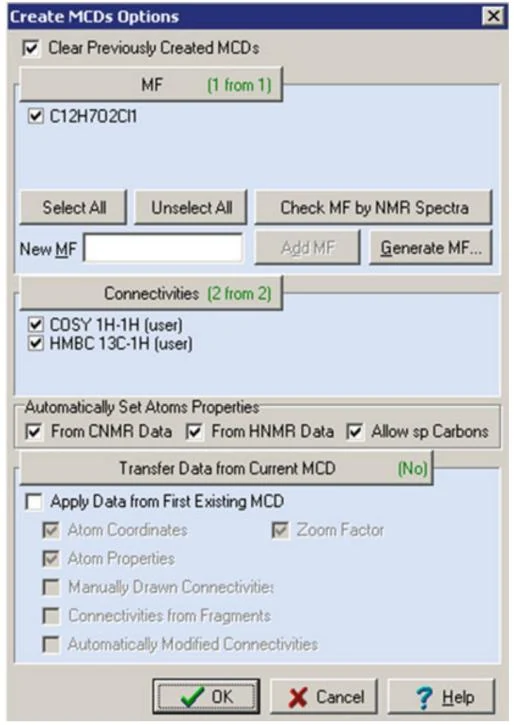
点击Generate MF 按钮即可打开分子式生成器对话框(图2.2)。
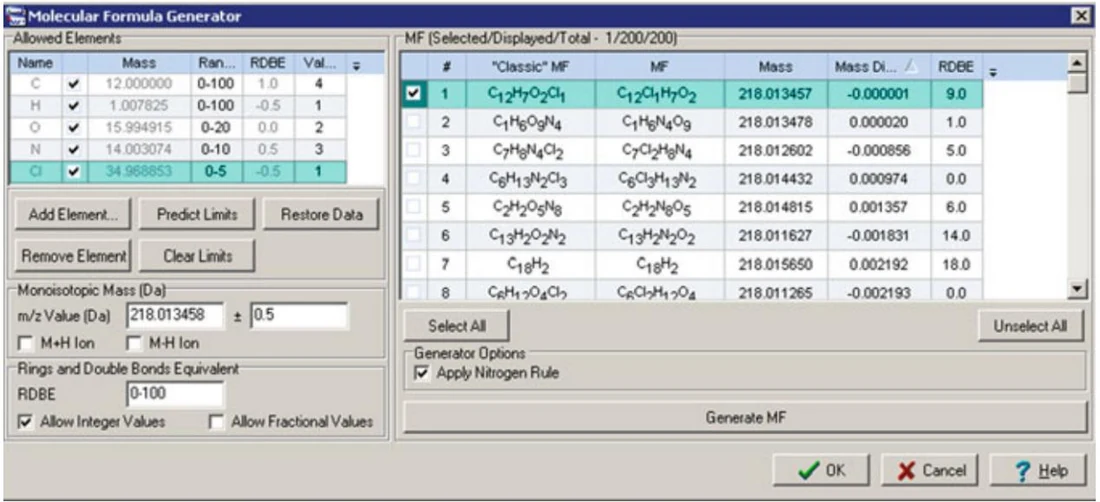
在分子式生成器界面右侧,展示了gymnopalyne 分子离子峰(m/z = 218.013458)匹配的候选分子式列表,质量容差(tolm)设为0.5 Da。界面左上角显示分子中可能存在的化学元素及用户设定的原子数目限制。这些限制基于一维和二维核磁共振数据、红外光谱特征(如3,700–1,300 cm−1 范围内的吸收带)以及质谱中分子离子簇的分布规律综合推断得出。若未施加任何元素限制,系统默认参数为:C(0–100)、H(0–100)、O(0–20)、N(0–10)。界面左下角需输入单同位素质量(monoisotopic mass)及质量容差(tolm)。用户可在RDBE(环与双键等效值)字段设定其合理范围(默认0–100)。若采用化学电离(CI)获取质谱数据,需勾选M+H Ion 或M−H Ion 复选框;若需应用氮规则(分子量与氮原子数的奇偶性关系),则勾选Apply Nitrogen Rule。点击Generate MF 按钮启动分子式生成,候选结果将实时显示在界面右侧。
在分子式生成过程中,候选分子式的数量取决于单同位素质量测定的精度及允许的元素组成范围。以gymnopalyne 的单同位素质量(218.013458 Da)为例,当质量测定精度为0.5 Da 且仅允许C、H、N、O 和Cl 元素时,系统会生成200 个候选分子式。如图1.17 所示,gymnopalyne 的正确分子式(C12H7O2Cl)位于列表首位(#1),因为生成结果会根据质量偏差值自动升序排列。若结合一维碳谱信号数目将碳原子数限制为12,候选分子式数量将锐减至9 个。
质量测定精度的提升同样显著影响候选分子式的数量:当质量精度设为0.05 Da 时,候选分子式为107 个;精度提高至0.005 Da 时仅剩8 个;而当精度达到0.0005 Da 时,系统仅会列出两个分子式(正确分子式与不合理分子式—C1H6N9O4)。若将容差设置为0.000005 Da,则仅生成唯一且正确的分子式。
实际应用中,通常综合运用两种策略以锁定单一分子式:一是通过核磁、红外等光谱数据约束元素组成范围;二是提高质谱仪的质量测定精度。在极少数无法明确确定分子式的情况下,可通过多次运行结构解析流程,分别输入不同候选分子式进行交叉验证,最终确定最合理的化学结构。
2.1.3 分子连接图(MCD)的构建
为了清晰、完整地展示骨架原子的性质及其连接关系,程序将骨架原子及其连接的氢原子(如CH3、CH2、CH、C 基团,以及通过1H NMR 和2D NMR 光谱识别的OH 和NH基团)整合到一个显示界面中,这种模式称为分子连接图(Molecular Connectivity Diagram, MCD)。如前所述,创建MCD 需要激活命令Structure Elucidation/Create Molecular Connectivity Diagram。随后,系统将弹出“Create MCDs Options”对话框(图2.1),该对话框支持以下功能:
选择分子式:使用单个分子式或一组可能的分子式创建MCD。如果选择了n 个分子式,系统将生成n 个MCD。
输入新分子式:直接在New MF 字段中输入新的分子式。
选择2D NMR 数据类型:指定用于创建MCD 的2D NMR 数据类型。
使用原子性质关联表(APCT):根据13C 和1H NMR 数据设置原子性质。
数据转移:将现有MCD 中的数据传输到新创建的MCD 中,可通过勾选相应复选框选择可转移的性质。
以gymnopalyne 的1H、13C、HMBC 和COSY 光谱数据为例,生成的MCD 如图2.3 所示。同时,系统会在Auto MCD 对话框中创建一份MCD 副本。所有在数据表中进行的修改都会自动同步到Auto MCD 窗口中,使用户在编辑User MCD 时能够实时查看初始MCD的状态。
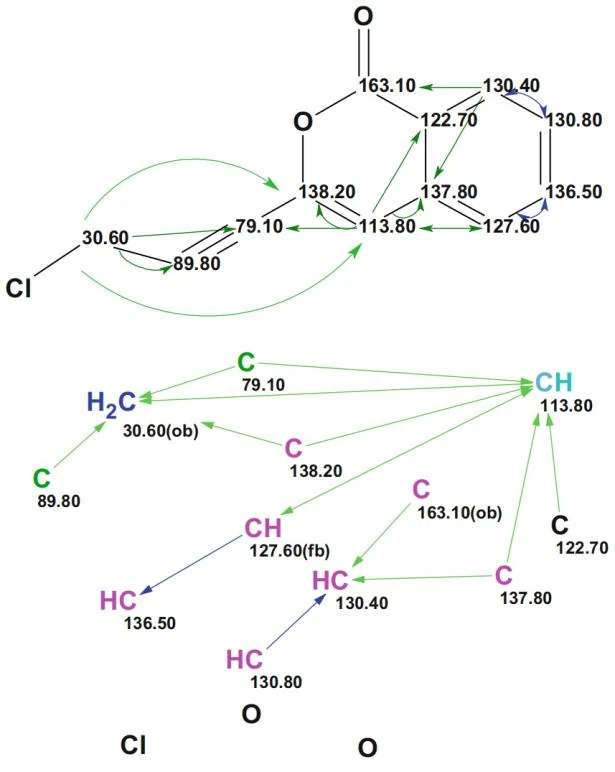
(MCD)。图片的上半部分显示了gymnopalyne 的结构及其二维核磁共振(2D NMR)连接关系。为了便于说明不同符号的含义,原子属性已根据gymnopalyne 的结构进行了人工调整在分子连接图(MCD)中,连接原子之间的距离(如果已知)会通过特定颜色进行标记。根据结构解析的基本公理(参见1.2.2 节),COSY 和HMBC 连接的长度默认分别设为1 键和1-2 键(标准连接),这反映了骨架原子之间的键数。在StrucEluc 中,标准长度的HMBC 连接用绿色表示,COSY 连接用蓝色表示(见图2.3)。如果化学家或程序在2D NMR 数据中检测到非标准连接,这些连接会用紫色标记。对于长度不明确的模糊相关性,则用虚线表示。这种可视化设计使用户能够快速判断两个原子之间的键数关系(如一键、两键或特定范围的键)。此外,用户可以通过工具栏按钮选择显示或隐藏来自不同2D NMR实验的信息。
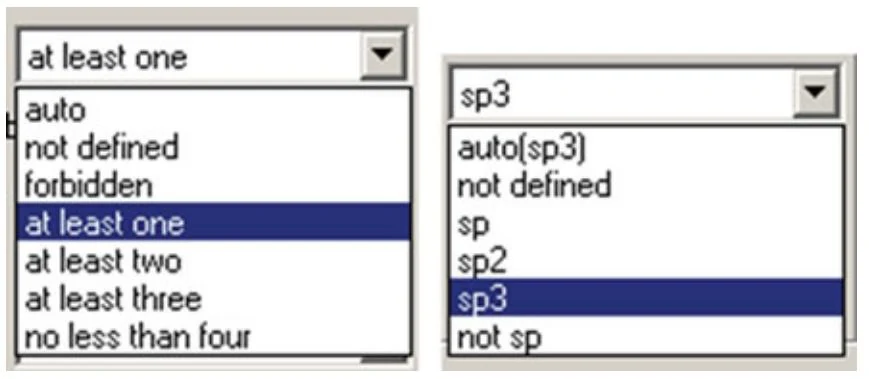
程序会分析CHn 基团(n = 0-3)的13C 和1H 化学位移,并尽可能自动设置原子属性参数,包括每个碳原子的杂化状态及其可能与杂原子相连的可能性。这一过程依赖于原子性质关联表(参见1.3.3.4 节)。与相邻杂原子的关系被标记为:“禁止”(fb)、“至少一个”、“至少两个”、“至少三个”、“四个”或“未定义”(nd)。碳原子的杂化状态则被指定为sp3、sp2、sp、非sp 或“未定义”。为了便于识别,不同杂化状态用特定颜色标记:sp3 为蓝色,sp2 为紫色,未定义(sp3 或sp2)为浅蓝色,sp 为绿色(见图2.3)。需要注意的是,程序在设置原子属性时会同时考虑13C 和1H NMR 化学位移,这些参数为后续的结构生成提供了重要约束条件。
如果在1H NMR 光谱中观察到来自结构单元(Ci )Hn 的明显多重峰,程序会设置连接到(Ci ) 碳相邻碳上的氢原子总数。这一性质由化学家在分析1H 光谱模式并参考耦合常数(如果已测量)后确定。原子性质的设置和编辑需格外谨慎,因为错误的假设(即错误的“公理”)可能导致正确结构被排除在输出结果之外。MCD 中的所有结构约束均会在结构生成过程中被应用。
图2.4 展示了一个窗口示例,其中详细列出了特定CH2 基团的所有性质;图2.5 则显示了用于设置杂原子相连可能性及原子杂化状态的下拉菜单。这些工具帮助用户更高效地完成结构解析任务,确保结果的准确性和可靠性。
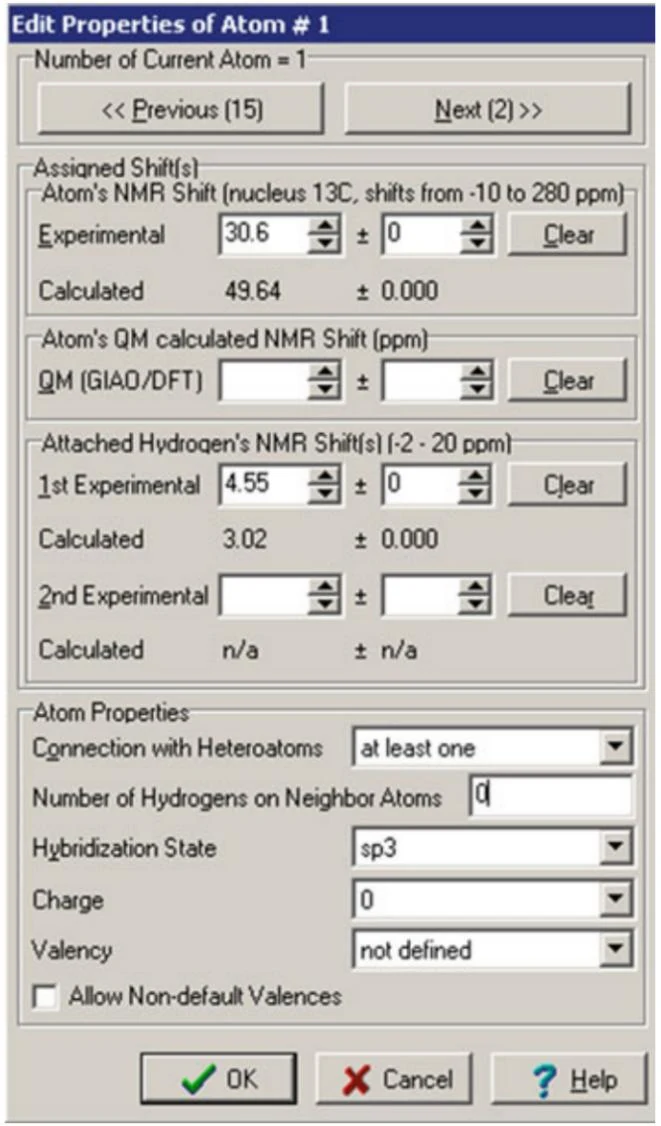
在本示例中,化学位移为30.6 ppm 的碳原子被确定为sp3 杂化状态,且必须与杂原子连接。由于1H NMR 光谱中4.55 ppm 处的信号为明显的单峰,用户将最接近C(30.6) 碳的相邻碳上的氢原子数设置为零。这一约束条件显著加快了结构生成过程,因为所有违反该条件的结构都会被自动排除。化学家还可以根据其他可用信息进一步调整这些参数,以确保解析结果的准确性。
为支持用户高效操作,MCD 工具栏提供了一组功能按钮,其用途通过屏幕提示进行解释,设计直观且易于理解。例如,若分子属于CHNO 类别,且用户将sp2 杂化的碳原子C(163.1) 标记为“至少两个”,则系统将仅生成(如果可能)O–C=O、N–C=O、O–C=N 和O–C≡N 等片段。
此外,化学家可以在原子之间绘制任意多重键,以引入建议的片段或设置特定官能团(如C=O、O–C=O、C≡C 等)。如果分子中包含杂原子且MCD 上显示有游离氢原子,还可以绘制O–H、N–H、NH2 等基团。这一机制为用户提供了一种快速直观的方式,将从1H NMR和/或IR/Raman 光谱中提取的结构信息直接整合到MCD 中。
用户还可以通过以下方式进一步优化结构生成:
在选定原子之间绘制特定长度的连接,以编辑连接长度在MCD 上绘制禁止连接,以排除不合理的结构可能性MCD 中呈现的所有结构约束均会在结构生成过程中被应用。所有编辑操作均可通过工具栏轻松完成,工具栏中的命令设计直观,并配有屏幕提示,确保用户能够高效地进行操作。
2.1.4 MCD 的一致性校验
Structure Elucidator 能够高效解析复杂化合物的分子结构,但其核心前提是光谱数据必须不存在矛盾。系统默认处理2−3JHH 和2−3JCH 耦合常数(即1.2.2 节定义的"标准"相关性),但当2D NMR 数据中出现键数超过3 的非标准相关性时,数据矛盾将显著影响解析结果。尽管非标准相关性对应的2D NMR 相关峰强度通常弱于标准峰,但两者在实际谱图中难以明确区分。虽然近年研究提出了相关性长度的识别方法[2–5],但目前尚缺乏常规NMR 技术能可靠区分不同耦合长度。因此,开发能够识别非标准相关性的2D NMR 数据分析理论具有重要价值。
StrucEluc 系统配备了专门的算法和程序[6],能够在大多数情况下检测出二维核磁数据中存在的非标准相关峰。该系统包含两种矛盾消除机制:一是通过延长特定连接路径的算法,二是采用更普适性的"模糊结构生成(FSG)"方法(详见2.3 节)[7]。无论采用何种方法,使用StrucEluc 进行结构解析的第一步都是检查分子连接图(MCD)中是否存在二维核磁数据矛盾,即进行数据一致性校验。
该校验算法基于对全部二维核磁相关信号的逻辑分析,采用归谬法进行严密论证。例如,当系统推导出"只有当至少一个碳原子呈现五价或六价(这种不可能状态)时数据才能自洽"的结论时,即可判定二维数据存在矛盾。需要说明的是,由于该算法包含启发式判断规则,不能保证在所有情况下都能检测出矛盾。实际应用表明,对于存在非标准相关信号的问题,该分析方法的成功率约为90%。通过此步骤,用户可确保MCD 数据逻辑自洽,为后续结构生成奠定可靠基础,显著提升解析效率。
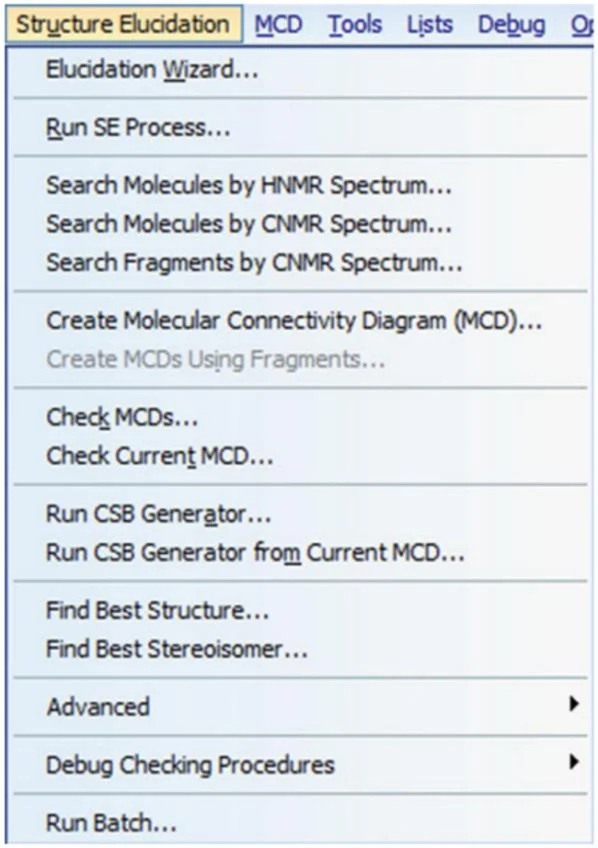
MCD 一致性校验操作流程在Structure Elucidator 中执行MCD 一致性校验时,需通过菜单栏激活Structure Elucidation/Check Current MCD…命令(图2.6)。
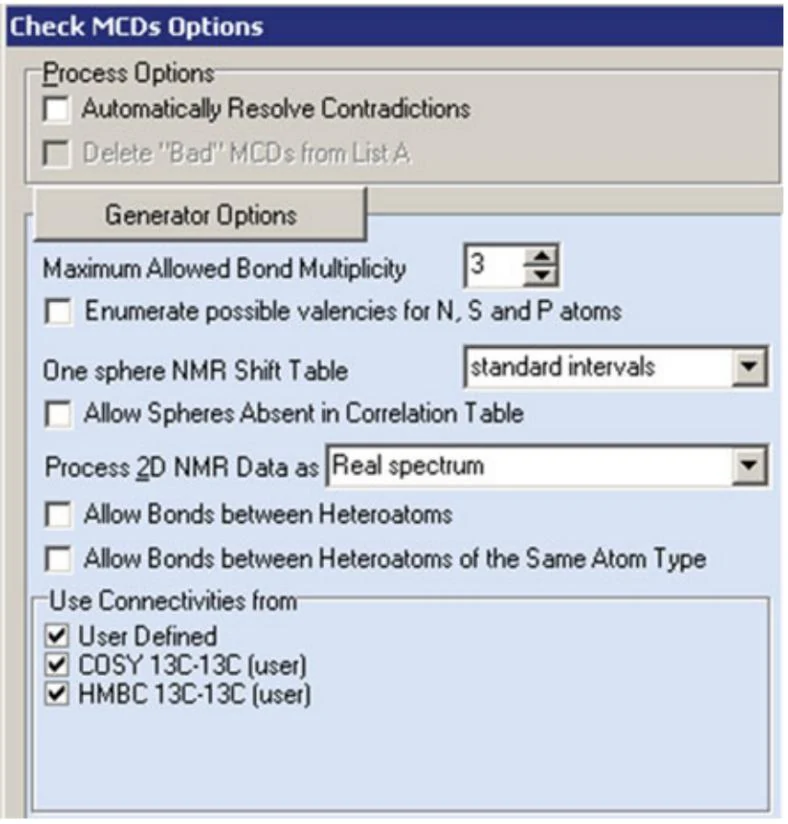
此操作将打开“Check MCDs Options”对话框(图2.7),其中包含首次运行程序时的典型设置。用户需确保所选选项与结构生成阶段设定的条件和假设保持一致。例如,当勾选Automatically Resolve Contradictions 选项时,程序会自动尝试将源自“可疑原子”的所有连接性延长一键,以消除潜在矛盾。其他复选框的功能虽直观易懂,但仍需特别说明:
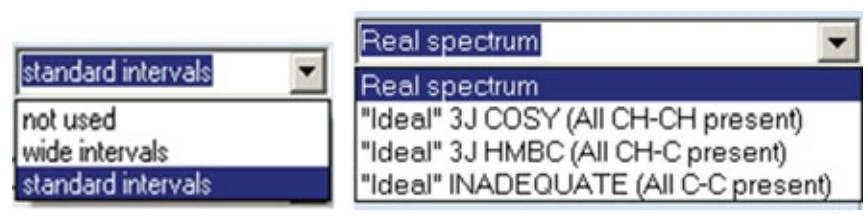
原子性质关联表(APCT)默认使用“标准区间”(Standard Intervals)模式(图2.7),通过预设化学位移范围自动设置原子性质。用户也可选择“宽区间”(Wide Intervals)模式以放宽限制,或在必要时通过“未使用”(Not Used)选项完全关闭APCT(图2.8 左)。在2D NMR 数据处理方面,当处理实际结构问题时需选择Real Spectrum 模式(图2.8 右),此模式严格依据实验数据进行分析,避免引入理论假设偏差。
MCD 检查通常耗时1-3 秒,完成后程序会弹出对话框,明确提示2D NMR 数据中是否存在矛盾(图2.9 展示了“检查MCD 结果”消息的示例)。
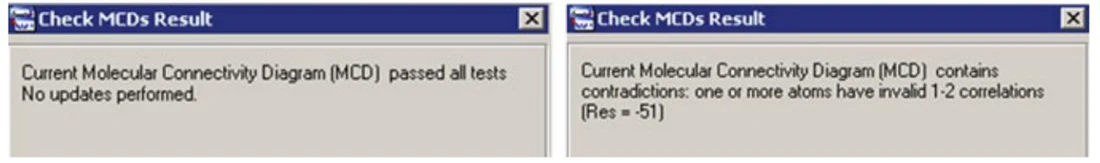
时显示,而右侧消息则在检测到矛盾时出现。
点击More… 按钮后,用户可查看关于“可疑”原子的详细信息以及程序建议的非标准连接最小数量。若未检测到矛盾,可执行严格结构生成(Strict Structure Generation);若存在矛盾,则需切换至其他解析模式(参见2.3 节)。
值得注意的是,在某些情况下(参见第5 章案例),即使程序未能识别非标准连接,系统仍可能生成符合所有预设连接性(包括非标准连接)的结构。这种矛盾的产生源于算法对非标准连接的漏检,可能导致两种结果:生成无效的化学结构,或生成正确结构但化学位移归属错误。因此,即使数据检查流程看似成功完成,算法仍可能遗漏非标准连接的存在。这些未被识别的非标准连接只能通过间接证据进行追溯,具体表现为以下特征:
(a) 13C NMR 谱偏差值过大:最可能结构的13C NMR 谱计算值与实验值之间存在显著偏差;(b) 与其他实验数据不一致:最可能结构与补充实验数据(如NOESY、ROESY 等)存在矛盾;(c) 1H NMR 谱数据不符:实验与计算的1H NMR 化学位移及裂分类型不一致;