2.3 非标准相关信号与模糊结构生成
2.3.1 非标准光谱响应的挑战与应对策略
基于CASE(计算机辅助结构解析)的2D NMR 方法能够在合理时间内完成分子结构解析任务,但需满足三个关键前提条件:(1)初始数据(NMR、质谱、红外等谱图数据及化学假设)必须真实可靠;(2)数据间不存在矛盾;(3)数据完整度足够——即所观测到的2D NMR 相关峰数量需充分覆盖分子内部的连接关系。当任一条件不满足时,获得正确解的可能性将显著降低。针对实验数据中可能存在的矛盾,StrucEluc 系统已开发并实现了一系列算法。本章将重点探讨2D NMR 谱图中出现非标准相关信号(Nonstandard Correlations, NSCs)时的结构解析策略。
通过大量计算实验验证,利用第2.1.4 节描述的MCD 检查程序,系统能够在90%的情况下成功检测非标准长度连接性的存在。这一结果具有重要意义,因为常规实验方法无法精确测定COSY 和HMBC 相关性的长度。检测到2D NMR 数据中的矛盾为研究者提供了关键信息,有助于优化结构解析策略。
需要注意的是,在某些情况下程序可能出现误报。例如,当至少一个原子的属性被错误标注(如将“fb”标签误设为“ob”)时,系统可能错误地报告非标准连接性的存在。此外,若研究对象中包含键合杂原子对,但程序选项未启用此类原子对检测,也可能导致“假阳性”报告。在这些情况下,程序关于矛盾存在的提示反而有助于化学家识别键合杂原子的存在(详见第三部分案例)。值得注意的是,在2D NMR 数据中不存在矛盾的情况下,系统未出现其他非标准连接性误检案例。
StrucEluc 系统不仅能够准确识别数据中的矛盾,在大多数情况下还能自动校正这些矛盾,从而确定正确结构。然而,当2D NMR 数据中仅包含一个HMBC 非标准相关性时,系统可能无法检测到NSCs 的存在。这是因为在1-2 个非标准相关性的情况下,原子在可能结构中的排列方式仍可能满足所有连接性的标准长度。只有当NSCs 数量较多时,这种原子排列的可能性才会显著降低。
隐式非标准连接性的存在通常通过结构生成及后续光谱库过滤过程显现。如果所有生成的结构均与光谱数据明显矛盾,程序将输出空结果文件。此外,若第一排名结构的化学位移偏差值(dA 和dN)超过3.5–4.5 ppm,也可能暗示程序中未检测到的矛盾。研究表明,在包含矛盾数据的任务中,95%的非标准连接性通过直接或间接方法被成功检测。
当有充分理由怀疑程序未检测到初始数据中的矛盾时,采用模糊结构生成方法(详见第5 章)很可能能够有效解决问题。
由于2D NMR 数据中可能存在隐式非标准连接性,最可能的结构通常需要通过独立方法进行额外验证。特别是,可以通过预测的化学位移和1H NMR 谱图中的多重峰来排除错误结构。然而,最有效的方法是应用模糊结构生成(FSG)。如果结构是在自动消除矛盾后生成的,仍然需要检查是否存在非标准连接性。这些连接性可以通过优化实验参数来验证自旋耦合值[4, 5]。
因此,并非总能找到非标准连接性并自动解决2D NMR 数据集中的矛盾。在实践中,通常会出现以下复杂情况:
1、程序检测到NSCs 并尝试消除矛盾,但报告无法自动消除矛盾。此时FSG 通常可以帮助解决此类问题,通常需要额外的实验来检测NSCs。
2、程序未能检测到非标准相关信号,并提示不存在矛盾。可能结果包括过滤后未生成或保存任何结构,或者生成错误结构,通常可通过13C 实验值与预测值之间的较大偏差识别,FSG 在此情况下同样有效。
3、程序检测到非标准相关信号并尝试消除矛盾,提示矛盾已消除,但实际上仍存在部分矛盾。这是因为并非所有非标准相关信号都被延长,其后果及解决方案与前述情况类似。
显然,最危险的情况是生成错误解,这可能发生在上述后两种情况中。即使程序无法消除检测到的矛盾(如第一种情况),检测到矛盾这一事实本身对于选择最佳问题解决方法也具有重要意义。
2.3.2 基于模糊结构生成的问题解决策略
在2D NMR 数据中存在nJ(n > 4)远程相关的情况下,自动消除矛盾的方法通常难以奏效。这是因为单纯增加两个核之间的键数无法生成正确的结构。此外,由于缺乏可进行逻辑分析的约束条件,即使n = 4,算法也无法保证检测并修正所有非标准相关性。成功进行逻辑分析并得到正确结构的概率主要取决于具有明确定义属性(如杂化类型和杂原子环境)的碳原子数量以及可用的2D NMR 相关性数量。
严重缺乏质子的分子是结构解析中最具挑战性的类型之一。随着分子尺寸和复杂性的增加,问题的计算复杂度显著提高,这进一步增加了解析难度。在2D NMR 数据中,非标准相关性(NSCs)的数量m 可能高达约20 个。为了消除矛盾,标准相关性长度a 的增量通常为1 至3。文献中的多个结构被用作示例,展示了包含大量NSCs 的情况,其中包括5J 和
6J 耦合常数(见图2.22)。这些案例为理解复杂分子结构解析提供了重要参考。
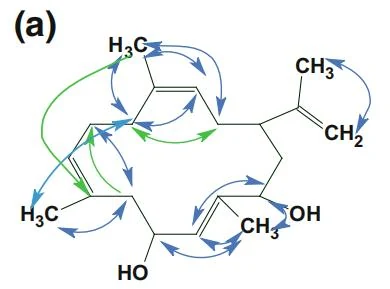
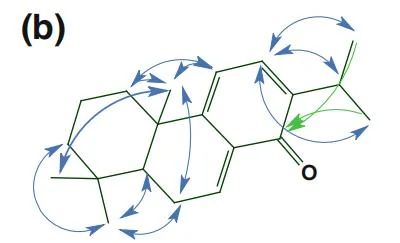
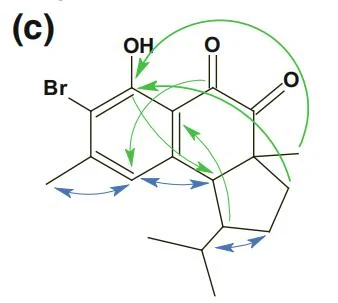
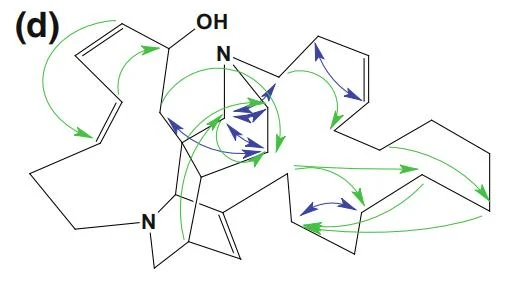
非标准COSY 相关性以蓝色箭头表示,HMBC 相关性以绿色箭头表示。在图例中,m表示非标准相关性的总数,a(增量)表示在模糊结构生成(FSG)过程中允许的相关性延长值。
为了克服上述困难,提出了一种计算策略,称为模糊结构生成(Fuzzy Structure Generation, FSG)。
2.3.3 模糊结构生成模式
通过大量计算实验,我们得出以下结论:当程序检测到非标准相关峰(NSCs)但无法使用第2.1.4 节描述的算法解决2D NMR 数据中的矛盾时,应采用模糊结构生成(FSG)来解决问题。此外,基于FSG 的2D NMR 数据结构解析很可能被视为一种通用的CASE 策略,因为它几乎不受2D NMR 数据中是否存在NSCs 的影响。
FSG 可以通过一组参数进行灵活控制,其中两个关键参数是:
m(非标准相关峰的数量)
a(需要增加的相关性长度键数)
然而,2D NMR 光谱数据本身无法提供这两个参数的确切值,它们只能在结构解析过程中逐步确定。研究发现,在许多情况下,用"删除"替代"延长"处理m 个相关峰,既能避免参数a 取值错误的风险,又能显著简化问题求解。具体实现方式是在选项设置中,程序可通过删除(而非延长)来处理异常相关峰(此时约定参数a 设为16)。
这种方法在二维核磁相关信号数量达到"最优"时特别有效——即总相关峰数量N 足够描述分子结构,且存在信息冗余的情况下。此时删除m 个相关峰既不会显著影响计算时间,也不会大幅增加输出文件规模。
然而,当需要考虑N 个相关峰中取m 个的所有组合时,计算量会急剧增加,甚至导致问题无法求解。值得注意的是,有研究者指出[15],某些ACCORDION 优化的远程异核化学位移相关实验会产生过多n≥4 的nJXH 型长程相关峰,这反而增加了结构解析的复杂度。
如果相关性总数N 较小,那么通过删除m 个相关性组合可能会过度减少解决问题所需的结构约束数量。在这种情况下,问题可能难以解决,因为2D NMR 数据的结构约束仅能略微减少可能的异构体总数。
无论采用延长还是删除相关峰的方法,FSG 应用中的关键点在于结构生成过程中需要检查的相关峰组合数量。例如,如果N = 60 且m = 5,那么相关性组合的数量nmath = ���将高达约550 万。每次结构生成尝试都必须使用这些组合中的每一个。需要从每个���数据集中生成结构,并将所有中间结果合并为最终输出文件。尽管StrucEluc 结构生成器速度较快,但在处理此类组合问题时,其效率显然不足。
为解决这一难题,系统配备了一种能够在保证不丢失正确解的前提下有效减少组合数量的智能算法。该算法的实施分为两个关键步骤:首先通过数据预处理将原始相关峰总数N精简至N0(用于构建组合的实际相关峰数量),预处理遵循以下规则:(1)排除所有模糊不清的相关峰信号;(2)当存在C1→C2 和C2→C1 双向相关峰时,仅保留其中一个,因为这种等效相关峰属于结构解析所需的数据冗余。
更为关键的第二步是基于初始二维核磁数据的逻辑分析结果:当识别出包含非标准相关峰(NSCs)的关联信号群时,系统会将这些相关峰组纳入所有生成组合中,从而显著降低初始组合数量。此外,算法还能实时识别并跳过那些因仍含有至少一个非标准相关峰而导致结构生成失败的无效组合。
这种优化策略使得模糊结构生成(FSG)即使在组合数nmath 极大的情况下仍能在合理时间内完成。但需注意的是,当分子连接图(MCD)检测程序未能识别二维核磁数据中的非标准相关峰时(发生概率约10%),系统将被迫尝试所有���种组合,这会导致求解时间急剧增加,此时上述方法效率显著降低。针对这种情况,引入用户自定义片段(UFs)和已知片段库(FFs)往往能提供有效帮助。该程序独具特色的一项功能是能够在结构解析的初始阶段就计算并显示FSG 过程中需要验证的实际组合数量,这一特性使用户可以提前评估待解决问题的复杂程度。
当以不同方式组合选项参数时,可以启动以下最合适的FSG 模式:
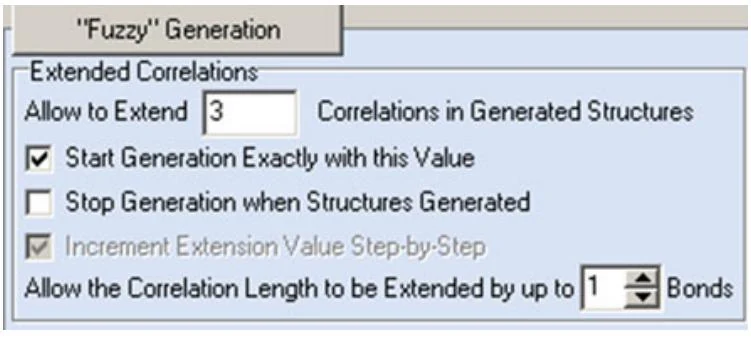
模式1:生成结构时,指定需要延长的相关峰数量(m = m0),并分配相关峰增量(a =a0)。在这种情况下,对于长度为1-2 个骨架键的HMBC 相关性,其下限和上限长度均会更新,连接性长度将延长至三个键。例如:m = 3,a = 1(见图2.23)。
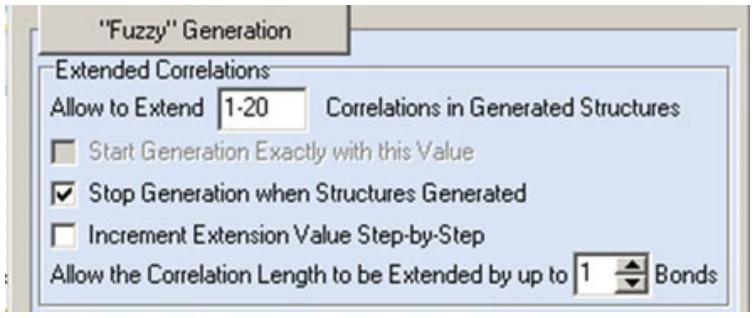
模式2:结构生成采用以下选项进行:假设可延长(或忽略)的相关峰数量不超过mmax(m = 1, 2, … mmax),而a 固定为a0。mmax 值定义为2D NMR 数据中允许的最大非标准相关峰数量。通常,mmax 值设置为20,以覆盖广泛的非标准相关峰范围(见图2.22)。程序首先以m = 1 进行结构生成。如果尝试失败,则m 值自动增加1,并以m = 2 进行新的运行,依此类推。如果在结构生成和光谱过滤后未存储任何结构,或找到不可接受的解决方案,则声明迭代失败。当m 达到mg 值时,程序认为2D NMR 数据一致,随后以m = mg 启动FSG。如果输出结构文件不为空且提供了可接受的解决方案,程序在完成m = mg 的结构生成后停止。例如:m = 1–20,a = 1(见图2.24)。
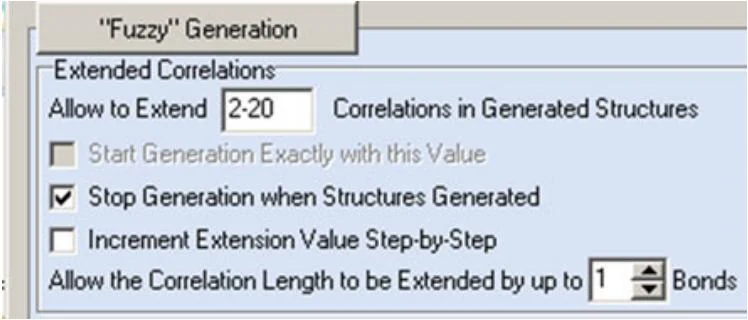
模式3:允许相关峰数量m 在mmin 和mmax值之间变化(mmin < m < mmax),同时设置固定的键数a0。通常,mmin 值是通过检查2D NMR 数据的一致性得出的。当满足与模式2 类似的条件时,程序停止。例如:m = 1–20,a = 1(见图2.25)。
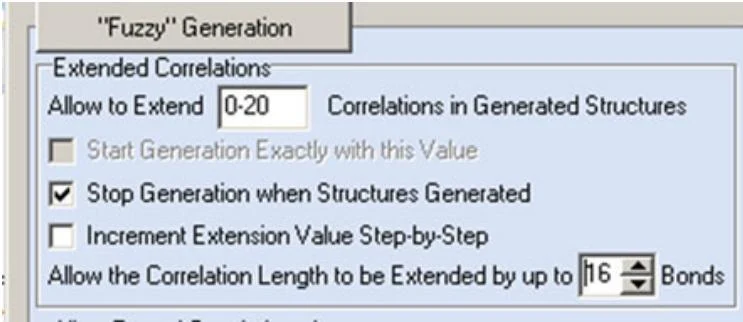
模式4:此模式是模式3 的广义化,其中m 值的变化区间由条件mmin < m < mmax 定义,且mmin = 0。该模式的特殊性在于它是一种“广义”结构生成模式,可以以m = 0 启动。在此模式下,程序首先检查给定2D NMR 数据集中不存在非标准相关峰的假设。如果数据集中不包含非标准相关峰,则程序完成结构生成过程,并按照先前描述的方法进一步解决问题(见第2.2 节)。如果以m = 0 的尝试失败,则程序会自动从m = 1、a = 16 开始执行FSG,并以模式3 中描述的方式继续解决问题。这种方法的优点在于无需对a 值做出任何假设。示例:m = 0–20,a = 16(见图2.26)。
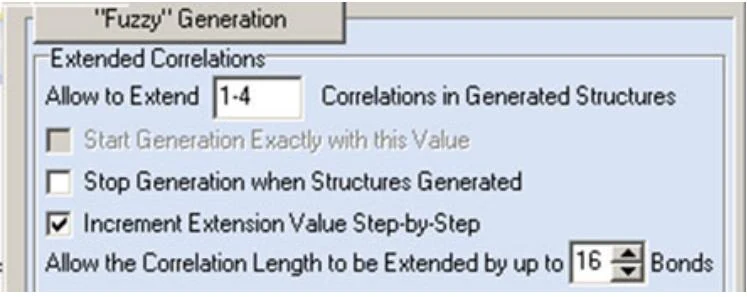
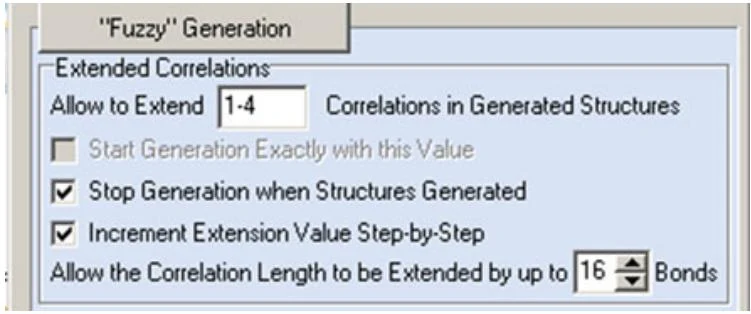
模式5:此模式在需要从mmin 到mmax 覆盖所有m 值的情况下启动,且不排除任何值。例如,如果在m = mg 时结构生成成功,则程序自动切换到m = mg + 1,依此类推,直到达到m = mmax。每一步生成的结构都会添加到前一步生成的结构中。此模式用于检查解决方案的稳定性,以确保在m = mg 和m = mg + 1 或更高步骤中找到的最佳结构是等效的。示例:m =1–4,a = 16:
(a) 生成在m = 1, 2, 3, 4 时进行,即使在某些m 值下未保存结构,生成也会继续到m + 1,依此类推(见图2.27)。
(b) 如果在某些m 值下未保存结构,生成将停止(见图2.28)。
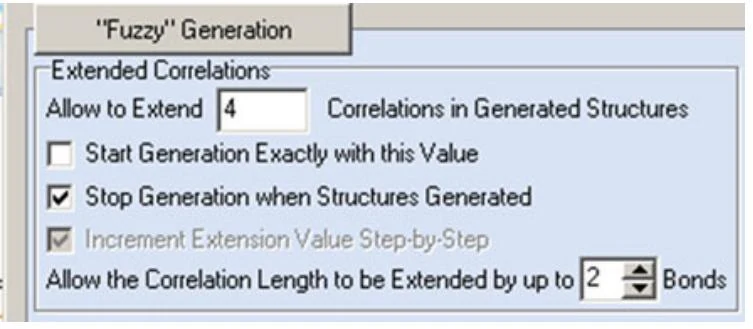
模式6:此模式类似于模式5,但其功能是生成所有非标准相关峰数量小于或等于m 的结构,给定a 值。相应的选项表示为{m < m0, a = a0}。FSG 执行的相关峰组合数量仅取决于N0 和m 值。与“逐步”模式不同,此方法将一些相关峰组合统一处理,理论上可以加快计算速度。在此过程中,仅延长HMBC 相关峰的最大长度(即两个骨架键长度)。例如,考虑C-1 和C-2 原子之间的HMBC 相关峰,其“标准”长度从1 到2 个骨架键变化。在此模式下,更新后的相关峰长度从1 到3 个骨架键变化。需要注意的是,此模式下生成的非同构结构数量与模式5 所有步骤生成的总数相同,但完成FSG 所需的总时间可能显著不同。示例:m =4,a = 2(见图2.29)。
模式7:此方法为研究人员提供了完全自动化解决问题的机会。要启动此模式,需选择“Allow Fuzzy Structure Generation”和“Determine Options Automatically”命令(见图2.10)。程序分析2D NMR 数据,并根据结果决定生成参数的选择及其应用策略。如果问题可以在Common Mode(不使用片段)下解决,则使用自动确定参数的FSG 非常有效。
需要注意的是,将参数a 设置为16 的模式4(见下例)可以被视为最全面的模式,因为原则上它能够解决2D NMR 数据中包含未知数量和未知长度的非标准相关峰的问题。
如果问题在给定选项下成功解决,程序将报告实际的m 和a 值。非标准相关峰可以从生成的结构中直观观察到,该结构将与所有COSY 和HMBC 相关峰一起显示。非标准相关峰以红色标记,易于识别。
除了上述控制FSG 的方法外,用户还可以通过选项将COSY 数据从FSG 过程中排除(见图2.10,“Use Connectivities from…”选项组)。在某些情况下,特别是当COSY 数据中包含大量非标准相关信号(NSCs)而HMBC 相关信号足够丰富时,排除COSY 数据能够显著加速问题的解决。此外,从COSY 和HMBC 谱图中移除弱峰,并将所有COSY 相关峰延长至三个键(4JHH 类型的相关峰),也可能对解析过程有所帮助。通过重复执行MCD 检查(分别开启和关闭COSY 数据),有时可以检测到COSY 数据中存在的非标准相关峰。
2.3.4 模糊结构生成的应用策略
多种FSG 模式的应用为结构解析提供了极大的灵活性。然而,模式的多样性也增加了复杂性,因为用户在解决特定问题时需要选择最优模式。在开始计算之前,无法确定哪种模式能够在合理时间内得到解决方案。
为探索是否存在一种通用的FSG 结构解析策略,我们选取了100 多个问题进行分析。这些问题中,HMBC 或COSY 谱图(或两者)共包含1 至18 个非标准相关信号(NSCs),对应的耦合常数范围为nJHH, CH(n = 4–6)。研究对象均为天然产物,分子中骨架原子数在15 至75 之间。
对于每个问题,NMR 光谱数据被输入程序并以MCD 形式图形化表示。随后,对每个问题应用2D NMR 数据矛盾检查程序。如果检测到NSCs,程序将显示非标准相关性的最小数量,并尝试自动解决矛盾。在成功的情况下,更新后的MCD 会以紫色标记修改后的相关性。
根据研究结果,所有问题被分为以下三类:
成功修正组(53 例):系统成功识别非标准相关峰(NSCs)并完成初始MCD 图的动态更新;
识别未修正组(34 例):程序检测到NSCs 存在,但无法通过自动逻辑分析实现MCD图的有效调整;
漏检组(13 例):系统未能识别数据集中存在的非标准相关信号。
基于上述分类体系,MCD 检查结果可覆盖所有可能的情况。根据MCD 验证结果,通过灵活选择不同FSG 模式或其组合,能够有效解决各类问题。为探索最优解决路径,本研究对每个案例尝试了多种FSG 模式,对于首次解析失败的案例,通过调整模糊生成参数最终实现成功求解。逻辑数据预处理经常能够显著减少FSG 过程中需要测试的相关性组合数量。图2.30 展示了比例ρ = nreal /nmath,其中nreal 是实际测试的相关性组合数量,nmath = ��0�是理论计算的组合数量。图2.31 则对此类组合进行了更深入的分析。
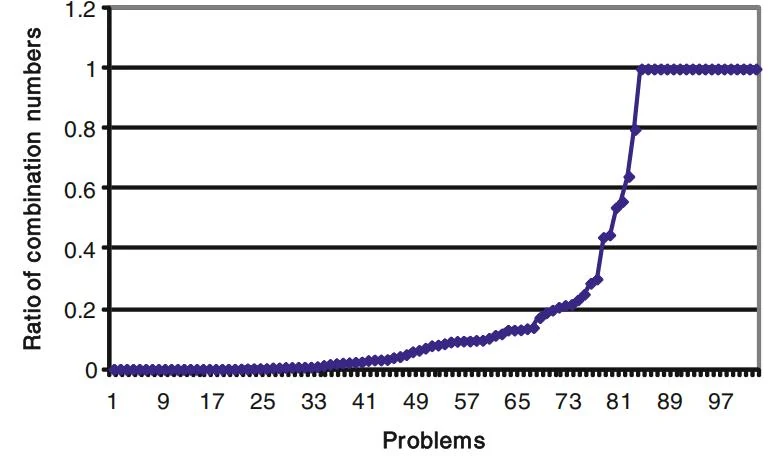
组合数量的比值。数据显示,当MCD 检查过程中未能检测到非标准相关信号(NSCs)时,程序难以有效缩减组合数量。
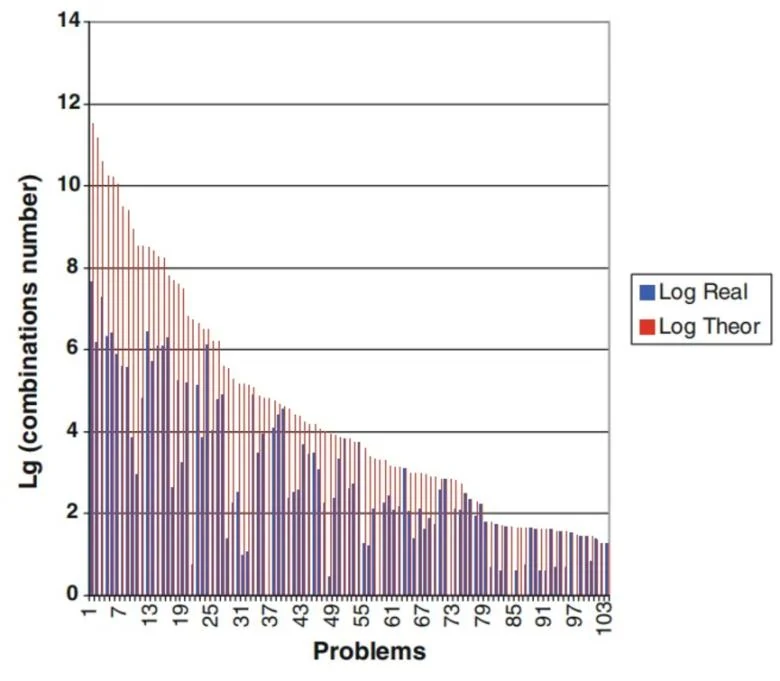
数据显示,理论组合数量可能达到数千亿量级(例如在20 个案例中,理论值缩减了104–106 倍),但实际测试组合数量仍保持在可操作范围内。尽管如此,结构生成算法的高效性(平均处理速度提升约3 个数量级)使得几乎所有问题都能成功解析。
然而,模糊结构生成(FSG)在解析图2.22 中结构d(C32H50NO2)时未能成功。该2D NMR 数据包含18 个非标准连接性(12 个HMBC 和6 个COSY 非标准相关峰;其中5 个为
5J 类型)。对于这种情况,理论上的相关性组合数量nmath 约为43 × 1012。尽管可以通过片段模式绕过这一困难,但在13C NMR 搜索过程中未能在数据库中找到合适的大片段。应用大用户自定义片段(UF)导致生成了一组极其庞大的MCDs,每个MCDs 都包含具有不同碳化学位移分布的UF。结果,这两种组合“爆炸”严重阻碍了问题的解决。希望通过算法的进一步开发,在MCDs 中实现片段的“植入”,从而简化此类计算难题的求解。
基于上述研究,我们总结了一些通用特征,这些特征有助于找到解决问题的适当方法。这些策略将应用于上述三类问题子集,并在以下小节中详细描述。
2.3.4.1识别到非标准相关峰且MCD 更新成功假设MCD 更新过程成功完成(所有非标准相关峰长度均已增加),则执行严格结构生成。如果获得可接受的解决方案,则应检查其稳定性。从初始MCD(而非更新后的MCD)启动模糊结构生成(FSG),选项设置为{m = mmin ÷ 20;在m = mg 时停止,a = 16}。如果严格生成和模糊生成的首选结构一致,则先前找到的解决方案将得到确认。当观察到不等式�����(1, mg)时(����(1) > ����(1) 为严格结构生成解决方案的首选结构偏差,�����(1, mg)为FSG在m = mg 时找到的相同结构偏差),可以得出结论:在MCD 更新过程中并非所有非标准相关峰都被延长,因此应使用mg + 1 重复模糊结构生成,直到�����(1, mg )达到最小值,并在m= mg + v 时获得有效解决方案。此时,相应结构被视为最可能的结构。
如果从更新后的MCD 进行严格结构生成时获得不可接受的解决方案(即����(1)> DA,其中DA 为阈值,或获得空结构文件k = 0),程序将自动切换到{m = mmin ÷ 20,在m = mg时停止,a = 16}模式。根据在问题解决初期评估的mg 值及问题复杂性(nreal 的大小和计算时间),用户可以启动FSG,选项设置为{m < m0, a = 16},其中m0 = 5、10 或15,以获得最可靠的解决方案。
2.3.4.2 识别到非标准相关峰但MCD 更新失败当程序检测到非标准相关峰(NSCs)但无法完成MCD 更新时,模糊结构生成(FSG)成为解决此类问题的有效途径。由于程序仅能显示NSCs 的最小数量,而无法确定其具体长度信息,建议采用{m = mmin −20,在m = mg 时停止,a = 16}的参数设置启动FSG。程序会实时显示实际测试的相关性组合数量nreal、当前m = mg 时的组合数量,以及预估的结构生成时间,帮助用户快速评估问题复杂性和计算资源需求。若时间预估在可接受范围内,优先推荐采用模式4 进行解析。
2.3.4.3 未检测到非标准相关峰若MCD 检查未发现非标准相关峰,可能包含以下两种情况:其一,2D NMR 数据中确实不存在NSCs;其二,数据中存在隐含的NSCs 但程序未能有效识别。针对这两种情形,均可通过{m = 0 ÷ 20,在m = mg 时停止,a = 16}的FSG 参数设置进行全面覆盖。当2D NMR数据中确实不存在NSCs 时,程序将在m = 0 条件下完成结构生成,并输出非空文件,用户可通过偏差值判断解决方案的可接受性。若偏差值超出预设阈值dA,或在光谱过滤后获得空输出文件,则强烈提示数据中可能存在隐含的非标准相关峰,需要进一步分析验证。
当逻辑数据分析未能检测到非标准相关峰(NSCs)时,在FSG 过程中需要测试的相关性组合数量无法减少,且在每个m 步中等于��0�,其中m = 1, 2, 3, …。这种情况可能导致显著困难,因为需要处理的相关性组合数量可能变得难以管理;如前所述,片段数据库(FF)和用户自定义片段(UF)在这种情况下可以提供帮助。
由于每个2D NMR 数据集及其对应问题的独特性,很难全面描述与FSG 相关的所有细节。第5 章将通过一系列示例展示如何在最小化用户假设的前提下,采用有效策略获得可靠的解决方案。
2.3.5 是否存在模糊结构生成的替代方案?
一些研究人员提出,可以通过为2D NMR 谱图中所有COSY 和HMBC 相关性设置默认值(如4JCH, HH)来解决非标准相关信号(NSCs)问题。这引发了一个关键问题:在多大程度上,延长所有2D NMR 相关性可以作为解决2D NMR 数据矛盾的方法?为回答这一问题,我们开展了一项研究[7]。
该研究试图量化分析:如果仅允许2−4J 范围内的相关性,结构生成时间将如何增加,以及获得的结构信息量将如何减少。研究结果表明,即使对于小分子,当将2−4J 耦合设为默认值时,输出文件的大小也会显著增加,生成时间则可能延长数百倍甚至数万倍。例如,在其中一个研究案例中,输出文件的结构数量从2 个增加到约3,000 个,而生成时间增加了650万倍!基于以上研究结果,我们得出主要结论:延长所有相关性不应作为解决2D NMR 数据中非标准相关性问题的通用方法。