3.15 挑战任务15
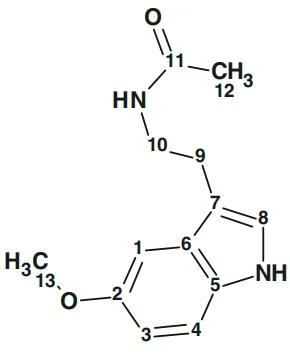
“未知物”的结构如下(分子式推断见表3.27):
事实数据(Factual Data)结论(Conclusions)
质谱(MS)
[M]⁺ = 232氮原子数量为0、2 或4(nN=0、2 或4...)
无[M+2]+峰不含硫(S)、氯(Cl)、溴(Br)
5 个峰为偶数质量可能存在氮(N)
核磁共振(¹³C NMR)
无分裂无氟(F)元素的存在。
13 个信号分子中至少含有13 个不同的碳原子(min. nC = 13)。
核磁共振(¹H NMR)
ΣH = 16最少氢原子数=18红外光谱(IR)
3244 cm⁻¹(极强)存在羟基(OH)/氨基(NH)/水(H₂O)
1587、1568 cm⁻¹(中等)芳环振动
1630 cm⁻¹(极强)推测为羰基(C=O)
原子数量范围C (13), H(16-18), O(0-5), N(0-6);DBE: 5-10生成的分子式C13H16N2O2,RDBE:7用于CASE 研究的NMR 光谱数据汇总于表3.28 中。虽然目标分子的结构并不算大,但其结构解析仍面临一定挑战:分子中存在两个NH 基团且不饱和度(DBE)高达7。因此,在结构推断过程中必须充分利用HMBC 数据以及COSY 谱中观察到的可靠相关性。
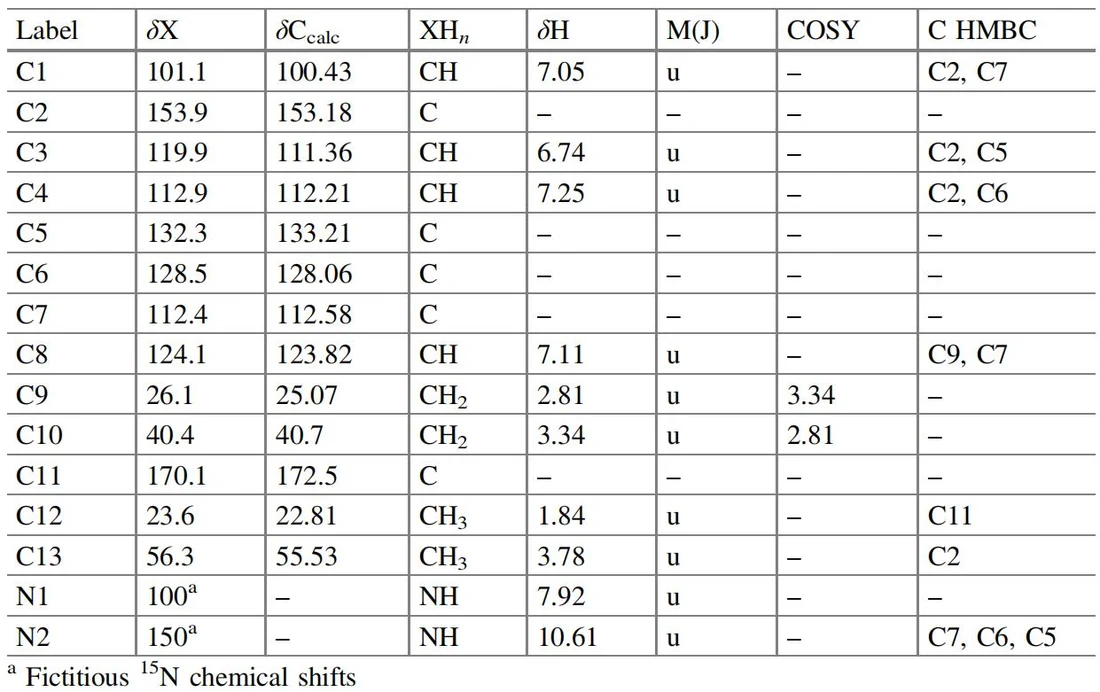
在¹H NMR 谱中(δH 10.61 ppm),其中一个NH 基团被成功鉴定,并显示出与¹H–¹³C HMBC 谱中C5、C6、C7 三个碳原子的相关性。然而,由于未获取¹H–¹⁵N HSQC 谱,氮原子N1 和N2 的化学位移信息缺失。为将这些原子纳入HMBC 连接的"网络"中,本研究采用了以下形式化方法:分别为N1 和N2 分配虚构化学位移(δN1 = 100 ppm;δN2 = 150 ppm),并在程序中创建虚构的¹⁵N NMR 数据和虚拟的¹H–¹⁵N HSQC 谱(如表3.28 所示)。尽管氮原子N2 的化学位移值为虚构数据,但表3.28 的最后一行仍具有重要的参考价值。这种人工干预的方法在类似情况下(如当OH 基团与HMBC 中的碳原子发生相关时)具有普遍适用性。
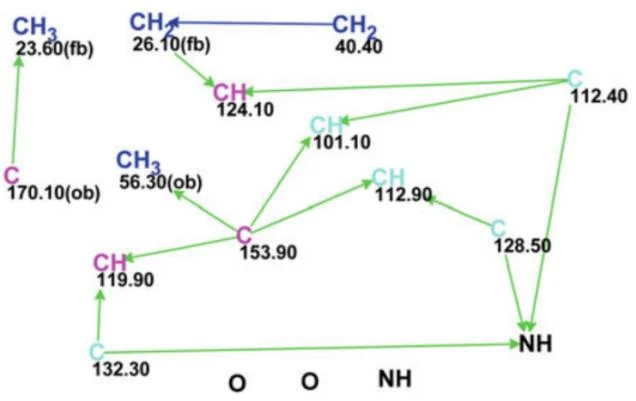
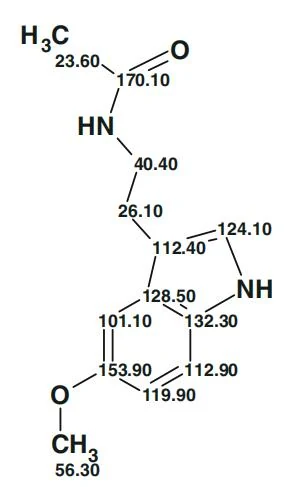
表3.28 中收集的数据对应的MCD 如图3.51 所示。在该图中,有五个浅蓝色标记的碳原子,其杂化状态被程序设定为"非sp"(即sp³杂化),以反映这些碳原子可能与两个杂原子相邻的结构特征。此外,考虑到IR谱显示存在较高概率的羰基(C=O)基团,碳原子C 170.10被手动赋予了"ob"属性。需要注意的是,尽管羰基化学键未在图中手动标注,但也不能排除存在C=N 基团的可能性。最后,图中以蓝色双箭头标记了一个COSY 相关性,这种标记方式遵循了StrucEluc 软件的默认设置规范。
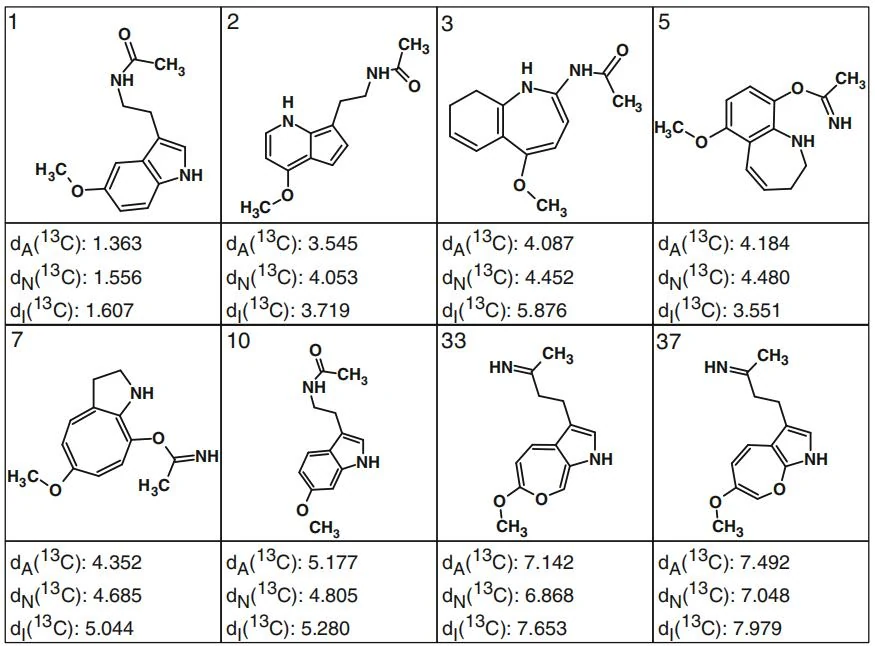
基于分子连接图(MCD)的结构生成结果显示:经三步筛选(k = 2,417 →1,246 →379),总耗时3.8 秒完成。图3.52 展示了排序输出文件中具有代表性的结构集,需特别说明的是,这些结构的排列顺序并非严格按文件序号(见标注的结构编号),其编排策略旨在双维度呈现:一方面突显生成结构的化学多样性,另一方面揭示结构间的相似性梯度。经过系统筛选,正确目标结构3.32(详见下文)从379 个候选分子中被明确鉴别。值得注意的是,尽管程序生成了含C=N 基团的结构变体,但基于算法评分体系,最接近目标结构的C=N 型分子仅位列第五顺位。
为验证系统在不同信息输入条件的影响,本研究在分子连接图(MCD)中手动绘制C=O键后重复结构生成实验。结果显示:候选结构数量经筛选k = 744 →468 →116,总耗时tg =1.2 s。实验证实,引入单一明确的结构约束(羰基定位)使生成结构数量和计算耗时均降低至原基准的三分之一水平。
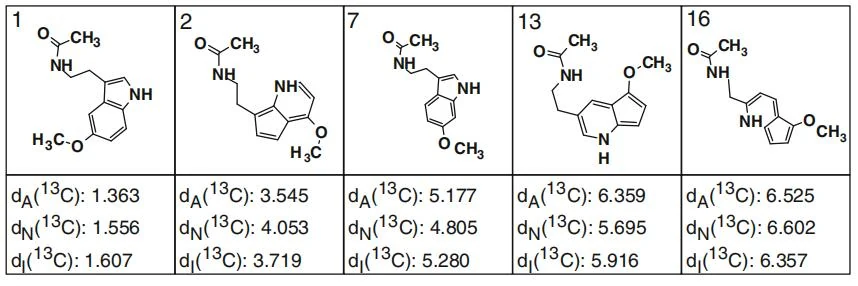
图3.53 通过¹³C 化学位移预测值的差异性分析,进一步量化了该约束对含羰基异构体的区分能力。