1.2 光谱-结构解析的逻辑基础
CASE 专家系统的发展历史始终强调一个核心观点[13]:分子结构解析的本质是从一系列光谱实验数据与结构之间的相互关系中,通过逻辑推理和假设筛选出最可能的结构。在计算机技术出现之前,这一方法已被长期隐含使用。无论是否采用计算机辅助方法,达到目标结构的路径始终一致,因为CASE 专家系统本质上是对人类专家方法的模拟。CASE 方法的主要优势包括:
“公理”透明清晰表达:所有关于光谱与结构之间相互关系的陈述(即“公理”)均被明确表达;
不漏掉任何可能的结构:从“公理”系统中得出的所有理论结果(结构)均通过完整推导获得,无任何遗漏;
高效解析:基于计算机的结构解析速度极快,显著节省科学家的时间与劳动成本;
多假设并行验证:若化学家针对特定结构问题提出多组可选公理,专家系统可快速从每组公理中生成所有结构,并通过比较所得结果识别最可能的结构。
我们假设读者已掌握分子光谱的基本原理(如质谱、一维和二维核磁共振、红外/拉曼、紫外等),并具备光谱数据的结构解析与阐明经验。本节将重点描述结构阐明过程中使用的知识体系[9,13,18],这些知识可按惯例分为以下几类。
1.2.1 基于特征光谱信号的公理与假设体系
我们称"公理"为基于先验知识且被广泛接受为真实的理论陈述。在解析新型未知化合物结构时,化学家通常依赖由数代波谱学家验证并建立的光谱-结构关联规律。尽管经验表明这些关联具有概率性特征,但研究者默认接受其在实际应用中的结构指示意义。
研究表明,描述特征光谱信号存在的理论陈述构成了结构解析理论的基础公理,而该理论体系符合公理化理论的基本特征[13,17,21]。此类公理通常可概括为以下形式:
如果分子中包含片段Ai,则该片段的特征信号会在特定光谱范围[X1], [X2], … [Xm]中出现,这些范围是该片段特有的。
这条公理可以用符号逻辑函数表示为:
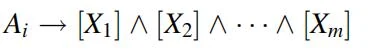
(1.1)
其中:
箭头“→”表示逻辑蕴含(implication),对应“如果…,那么…”的表达式;
符号“∧”表示逻辑与(conjunction),对应“且”的连接关系。
示例解析:
若分子中存在CH2 基团,则红外光谱中应出现约1,450 cm-1 的振动吸收峰(CH2的剪式振动)。
若分子中存在CH3 基团,则红外光谱中应出现1,450 cm-1 和1,380 cm-1 两个特征吸收峰(分别对应CH3 的反对称和对称弯曲振动)。
根据式(1.1),上述公理可形式化表示为:
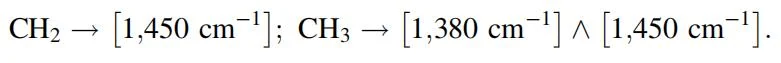
类似地,对于13C NMR 特征化学位移,以下蕴含关系也是公理的典型示例:
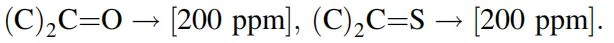
当利用特征光谱信号检测分子中可能存在的片段时,化学家通常采用以下典型"模板"形式表述:
如果在光谱范围[Xj]中观察到特征信号Xj,则分子中至少包含集合A 中的某个片段,其中A = {Ai, Ak, … Al},这些片段均以在[Xj]范围内出现的Xj 信号为特征。片段Ai, Ak, … Al 构成一个有限集合A。
这一断言可符号化为:
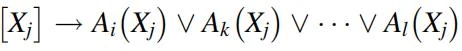
(1.2)
其中:
符号“∨”表示逻辑或(disjunction),对应“或”的连接关系。
表达式(1.2)的含义是:特征信号Xj 的出现可由集合A 中任意片段的组合解释。
需要指出的是,这一陈述是假设而非公理,因为特征信号Xj 可能由尚未被认知的片段产生,或者源于已知片段间的分子内相互作用。例如,若红外光谱在1,450 cm-1 处观察到吸收带,则分子可能包含CH2 基团(剪式振动)、CH3 基团(反对称弯曲振动)、两者共存(1,450 cm-1 带重叠),或其他未知官能团或子结构(如环丙烷的C-C 伸缩振动)。这一陈述可形式化表示为:1,450 cm-1→(CH2 ∨CH3 ∨α),其中α为"伪片段",表示特征信号来源的未知因素。
对于13C NMR 示例,我们可提出以下假设:200 ppm →(C)2C=O\/(C)2C=S。需要注意的是,若Ai →Xj 为真,则根据形式逻辑,逆蕴含Xj →Ai 可能为真或非真。换言之:
在光谱中观察到属于片段特征信号范围[Xj]的信号Xj,并不必然意味着存在对应的片段Ai(Xj)。
逻辑规则[17],与表达式Ai →Xj 等价的真蕴含关系是:
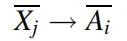
这条蕴含关系表明:如果在光谱范围[Xj]内未出现特征信号Xj,则被研究的分子中不存在对应的片段Ai。
后一陈述可视为基本公理Ai →[Xj] 的另一种等价表述,且与化学常识高度一致。例如,若在3,700–3,000 cm-1 范围内未出现红外吸收带,则分子中不存在羟基(-OH)。
在结构解析过程中,判断某片段是否存在需综合考虑其在所有可用光谱中的特征信号。通常情况下,这一过程可形式化表示为:
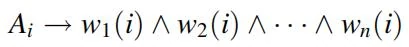
(1.3a)
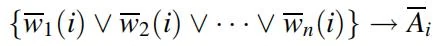
(1.3b)
在这里,关系式(1.3a)和(1.3b)中的变量wj 表示片段Ai 在所有可用光谱(如红外光谱、1H NMR 和13C NMR)中分配的特征信号。
方程(1.3b)与方程(1.3a)等价,是通过对合取式w1(i) ∧w2(i) ∧… ∧wn(i)应用德摩根定律[9, 17]推导得出的。
方程(1.3b)的解读可描述如下:
如果在至少一种可用的实验光谱中未观察到片段Ai 的任一特征信号w1, w2, … wn,则该片段Ai 不存在于未知分子的结构中。
需要强调的是,方程(1.3b)提供的“模板”使化学家在未知化合物的结构分析中能够得出最可靠的结论。原因在于,我们使用公理(1.3a)的等价形式(1.3b)来排除某个片段的存在,而如前所述,逆蕴含关系Xj →Ai 仅是一个假设,其真实性可能成立也可能不成立。根据科学哲学的观点,假设的真实性需要通过实践验证。在我们的案例中,当真实结构被确定时,所提出假设的真实性才能得以确认。
例如,以下特征光谱范围是醛基的特异性信号:红外光谱[1,720 cm-1]、13CNMR[200 ppm]和1H NMR[9.5 ppm]。相应的逻辑关系为:
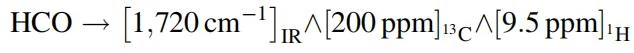
公理的等价形式可表示为:
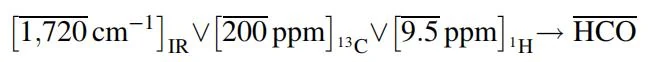
显然,如果在[1,720 cm-1]范围内未出现任何红外吸收带,或者在13C 或1H NMR 光谱的对应区间内未检测到任何共振信号,则可以得出结论:被研究的分子中不包含醛基。值得注意的是,在某些特定情况下,方程(1.3b)可能被违反。例如,季碳原子的13C NMR 信号有时强度极低,无法与噪声水平区分开来。人类专家对1D 和2D NMR 光谱的分析可以帮助解决分子式与13C NMR 光谱信号数量之间的矛盾。
当需要鉴定新合成或分离的化合物时,第一阶段通常是通过可能存在于分子中的结构基团来表征未知物。对专家推理方法的研究表明,结构基团光谱分析(structural-group spectral analysis,SGA),无论是手动还是计算机化,除了上述假设外,还基于以下假设:
• 每个片段Ai∈A 在分子中的允许环境被严格定义时,其具有明确的光谱特征范围。
• 被分析的分子必须是加性的,或至少包含一些封闭的自包含基团。加性分子会产生加性光谱。
• 只有Ai∈A 的片段可以参与问题的解决。所有其他可想象的片段Ax ∉A 将不予考虑,但它们可能在结构生成过程中涉及。
• 在解决问题时,所有实验光谱的光谱特征(如化学位移、频率)均被视为结构元素Ai∈A 的潜在特定属性,并且只能以Ai 片段的术语来解释。
• 在SGA 期间选定的片段的化学组成和不饱和度U 必须与分子的经验公式一致。
• 在解决问题时,结构基团分析得出的每个可能的片段集合必须能够解释实验光谱中所有被视为特征的光谱特征。
所有这些假设(无论是明确还是隐含的)均被专家在结构-基团光谱分析(SGA)过程中使用。基于结构-基团光谱分析构建的数学模型和专家系统仅以明确的形式使用这些假设,因为这些“公理”已被纳入系统的知识库和算法中。
因此,化学家在分子结构解析过程中可能遭遇的各类“现实矛盾”,在专家系统中也会以相似形式呈现。
本节通过案例论证,有机分子的结构-基团光谱分析(利用NMR 化学位移、IR 频率等特征光谱信号)能够基于符号逻辑实现形式化描述。研究发现,特定亚结构与其对应光谱特征之间的关联性可通过逻辑函数精准表达。文献[9]进一步证实,通过将这些逻辑关系与实验光谱数据进行联合分析,算法可穷举未知化合物中所有潜在的亚结构组合。值得强调的是,运用逻辑演算解决谱图-结构问题不仅是数学工具的应用,更是解码专家在未知物结构解析中思维路径的重要方法论。当结构-基团光谱分析算法被植入专家系统时,其内置“公理体系”可能暴露出逻辑矛盾,此时需依赖化学家利用交互式工具进行人工干预与修正。
1.2.2 二维核磁共振波谱学的公理与假设
二维核磁共振(2D NMR)光谱学是一种理论上能够仅凭实验数据(无需依赖谱图-结构关联假设)从头解析分子结构的方法。对于某些小分子(尤其是富含质子的体系),2D NMR数据可提供足够的结构信息,从而将合理结构的候选范围缩小至可操作水平。然而,在实际应用中,仅通过2D NMR 数据从头解析大分子结构(不借助任何基于谱图-结构关联的公理)通常难以实现。因此,研究者常将一维(1D)与二维(2D)NMR 数据协同联用,以解决有机化合物研究中的实际分析难题。
经验表明,分子的大小并非制约基于2D NMR 的计算机辅助结构解析(CASE)系统的关键瓶颈。真正影响解析效率的核心因素在于分子骨架中传递结构信息的氢原子数量及其骨架杂原子数目。当分子中氢原子丰度高且杂原子数量较少时,结构解析过程通常显著简化。
所谓"Screws 规则"指出:当分子中骨架原子数n(X)与氢原子数n(H)的比值大于2 时(即n(X)/n(H) > 2),该结构问题将转变为一项挑战。
迄今为止,尚未建立起分子组成与专家系统推导的合理结构数量之间的特定依赖关系,这是因为解决问题的方式需根据具体问题的特性来选择(参见第1.2.2 和1.2.3 节)。此外,问题的复杂性与诸多无法在尝试解决前预判的因素相关联。
例如,问题的复杂程度取决于重原子及其所连氢原子是否在分子骨架周围呈"均匀"分布。若分子中存在至少一个"沉默"片段(即不含连接氢原子的片段),则该片段可能中断HMBC和COSY 相关信号的传递链。正如隐品碱家族化合物研究所报道的[22,23],这将导致结构假说的数量呈指数级增长。
当利用二维核磁共振(2D NMR)数据解析分子结构时,化学家(或模拟化学家推理方式的专家系统)需从分子式出发,结合二维核磁共振谱学数据推演出可能的结构。面对全新的有机化合物的结构鉴定时,研究者必须对全新的2D NMR 谱图数据进行解析。此时无法依赖针对特定谱图-结构关联矩阵的有效"公理",因此需根据2D NMR 光谱学的重要公理——即普适性规律——构建最可能的结构假说。
在深入探讨这些公理之前,有必要简要说明计算机辅助结构解析(CASE)作为"逆问题"(inverse problem)的本质特征。当我们通过一维(1D)和二维(2D)NMR 谱图解析新化合物结构时,最终目标是确定该分子中所有原子间的化学键连接方式(及其键级)。此类问题属于典型的逆问题。逆问题广泛存在于多学科领域中,其核心特性在系列专著(如[24])中已有系统论述。
逆问题的核心特征在于其普遍存在的多解性,需通过引入附加信息(施加约束条件)筛选出唯一解。
通过对基于二维核磁共振技术(HSQC、HMBC、COSY 等)的计算机辅助结构解析(CASE)策略进行系统性分析可知,整个结构解析问题可分解为两个需按序求解的逆问题组合。
第一个问题可以表述为:确定分子中所有(如果可能)在NMR 谱中观测到自旋耦合的原子(核)对。
这一目标通过以下步骤实现:在1D 和2D NMR 谱中进行峰识别,并依据2D NMR 谱的谱图-结构解析规则枚举所有相互作用的原子对。
第二个问题则是生成所有满足以下条件的分⼦结构:
符合第一个问题的求解结果(结构约束)
满足化学结构与其特征光谱参数间的已知关联(通过谱图-结构关联表验证)
与现有化学知识体系保持一致如前所述,通过逐步对生成的结构施加不同的新约束条件,最终可筛选出唯一的结构(即问题的唯一解)。由此可见,第二个(主要)逆问题的解决高度依赖于第一个问题的求解结果。如果第一个问题的解中包含了错误的自旋耦合(相关信号),则获得第二个问题的正确解将变得十分困难。要深入理解计算机辅助结构解析(CASE)问题的本质,掌握结构解析的艺术至关重要。
现在,我们将尝试以显式形式表达二维核磁共振(2D NMR)光谱学的公理并对其进行分类。2D NMR 光谱学有多种形式,其中最重要且常见的是同核(¹H–¹H)和异核(¹H–¹³C)光谱。尽管X₁–X₂型异核相互作用(X₁和X₂为磁性活性核,但非¹H 或¹³C)在理论上是可能的,但此类谱图在实际中较为罕见,且除标记材料外,通常极难获取。
通过逐级施加约束条件对生成的结构进行筛选,最终可获得唯一确定的结构解。需要特别指出的是,核心逆问题(即第二个问题)的求解质量严格依赖于初始自旋耦合信号解析的准确性。若初始逆问题(第一个问题)的求解过程中存在自旋耦合信号误判,将导致后续结构解析产生系统性偏差。因此,要深入理解计算机辅助结构解析(CASE)问题的本质,掌握结构解析的技巧是至关重要的。
当前研究致力于将二维核磁共振(2D NMR)光谱学的公理体系进行显式表达与系统分类。从实验技术视角而言,2D NMR 主要涵盖两大类谱学方法:同核¹H–¹H 谱用于解析质子间的耦合网络,而异核¹H–¹³C 谱则是揭示碳氢骨架连接关系的核心技术。值得关注的是,X₁–X₂型异核相互作用(X₁/X₂为除¹H、¹³C 外的磁性活性核)虽然理论层面成立,但在实际检测中面临重大挑战——除同位素标记样品外,常规实验条件下此类谱图的获取几乎不可行,这主要源于天然丰度核的灵敏度限制及信号解析复杂度。
二维核磁共振(2D NMR)数据应用于计算机辅助结构解析(CASE)的必要前提是完成所有含质子碳原子核(即CHn基团,n=1-3)的化学位移归属。该信息通过HSQC(或HMQC)谱数据提取,其核心公理可表述为:
将二维核磁共振(2D NMR)数据应用于计算机辅助结构解析的一个必要条件是对所有含质子的碳原子核(即所有n 取值为1 到3 的CHn 基团)进行化学位移归属。这些信息是通过使用以下公理,从HSQC(也可使用HMQC)数据中提取出来的:
若在HSQC/HMQC 谱中观测到峰信号(δCi, δHi),则化学位移为δHi 的氢原子Hi 必定连接于化学位移为δCi 的碳原子Ci。采用符号逻辑可形式化表达为:
分子骨架解析的核心结构信息来源是COSY 与HMBC 谱所提供的关键相关信号。在核磁共振波谱学实践中,我们将符合以下公理体系的相关信号定义为标准相关信号,这些公理源自核磁共振专家的长期实验观测与经验积累:
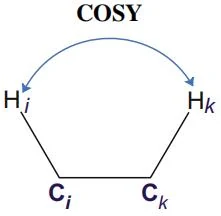
若在COSY 谱中观测到峰信号(δHi, δHk),则表明分子中存在通过质子Hi(δHi)与Hk(δHk)介导的相邻碳原子Ci–Ck 间的化学键连接,该结构关系可通过逻辑蕴含式表达为:
peak(δHi, δHk) →bond{Ci–Ck}
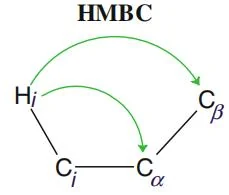
若在HMBC 中观测到峰信号(δHi, δCk),则表明分子中碳原子Ci 与Ck(k = α, β)之间间隔一个或两个化学键,即存在以下两种连接方式:(Ci)–(Cα) 或(Ci)–(Cα)–(Cβ),该结构关系可通过逻辑蕴含式表达为:
peak(δHi, δCk)→bond{Ci–Cα} ∨bond{Ci–Cα–Cβ}在一般情况下,碳原子Cα可以被任何杂原子X 取代。标准COSY 和HMBC 相关信号的特征耦合常数分别为³JHH(COSY)和²⁻³JCH(HMBC),因此在标准相关信号中,相互作用的核间最大拓扑距离为三个化学键。
类似地,基于NOE 效应(NOESY/ROESY 谱)用于结构解析的核心公理可表述如下:
若在NOESY 或ROESY 谱中观测到峰信号(δHi, δHk),则表明原子Hi 与Hk 之间的空间距离小于5 Å,该关系可通过逻辑蕴含式表达为:
peak(δHi, δHk)→{dist[(Hi, Hk)] < 5 Å}需要特别指出的是,一维(1D)与二维(2D)核磁共振公理的逻辑解释存在本质差异。以COSY 谱为例,其核心公理存在第二种等价形式:
若分子中不存在化学键Ci–Ck,则在COSY 谱中不会观测到峰信号(δHi, δHk),其逻辑表达式为:
)δH,δH(eak p→)}(C–){(C bond k i k i根据逻辑蕴涵的基本性质,由COSY 公理推导出的逻辑表达式
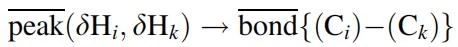
其真值具有不确定性。这意味着:当COSY 谱中未检测到峰信号(δHi, δHk)时,既不能证实也不能证伪分子中Ci–Ck化学键的存在——该化学键可能存在,也可能因物理因素(如耦合常数过小或信号重叠)而未被观测到(参见第1.2.4 节图1.7 和1.8)。
基于此,专家系统在结构解析中采取保守策略:不会仅因特定二维核磁共振(2D NMR)峰信号[如k δ(Hi, Hk)]的缺失而排除含有(Ci)–(Ck)键的可能结构。这一原则同样适用于HMBC和NOESY 的数据解析。值得注意的是,通过形式化逻辑表达的2D NMR 公理体系所得结论,与专业人员在谱图结构解析中的经验判断完全一致。
尽管这些公理在绝大多数案例中成立,但存在诸多例外情形,此类特殊信号被定义为非标准相关信号(Non-Standard Correlations, NSCs)[25, 26]。
非标准相关信号(NSCs)是指相互作用的核间拓扑距离超过三个化学键的耦合信号,即耦合常数满足n>3 的nJHH或nJCH。
由于标准相关信号与非标准相关信号难以区分,NSCs 的存在成为从2D NMR 数据中逻辑推断分子结构的主要障碍。若2D NMR 数据中同时存在无法区分的标准与非标准相关信号,由此衍生的“公理”集合将包含逻辑矛盾。
这意味着无法从这些公理中推断出正确结构,此时结构解析问题可能无解或得出错误结论:生成的结构候选集中将不包含真实结构(最佳情况下可能生成化学位移归属错误的“正确结构”)。本书第5 章将详述此类案例,并展示如何通过Structure Elucidator 系统解决初始数据中的矛盾问题。
遗憾的是,目前尚无常规且可靠的核磁共振(NMR)技术能够明确区分二维核磁共振(2D NMR)谱图中标准相关信号与非标准相关信号。尽管如此,耗时的INADEQUATE 实验及其衍生版本ADEQUATE 实验的应用有助于克服这些矛盾。然而,这些技术同样建立在自身的理论假设之上,这些假设在某些情况下可能并不成立。
1.2.3 结构组装所需的结构假设
当一维(1D)和二维(2D)核磁共振(NMR)谱图中的信号峰被归属,并且所有二维相关信号被转化为分子骨架中重原子之间的连接关系后,可行的分子结构应通过严格片段(strict fragments)和模糊片段(fuzzy fragments)的组合来组装。严格片段基于一维核磁共振(1D NMR)、二维COSY 谱以及红外光谱(IR)数据提出,同时也可能包含研究者根据经验提出的假设;而模糊片段则主要来源于二维HMBC 数据。在组装结构时,需要做出一系列可靠对的决策,这相当于构建一组公理化的假设。至少需要明确以下几点:
允许的化学组成:如CH、CHO、CHNO、CHNOS、CHNOCl 等。这一选择基于核磁共振(NMR)和光学光谱、分子离子簇的模式、质谱(MS)中特征性的m/z 值、化学考虑和规则(例如所谓的氮规则[10]),以及其他可能获得的信息(如样品来源等)。显然,如果研究者排除了某些实际存在于未知样品中的化学元素的可能性,则真正的分子将永远无法被识别(参见[18]及第5.13 节中的示例)。
可能的分子式:从一组可能的精确分子质量中选择。提出正确的分子式对于计算机辅助结构解析(CASE)系统至关重要,并且在去重复分析中也非常重要。
具有可变价态的原子的可能价态:如N(3 或5)、S(2 或4 或6)、P(3 或5)。如果无法获得15N 和31P 核磁共振谱,则原则上应尝试这些原子的所有可能价态。显然,手动进行如此全面的搜索几乎是不可能的。应用CASE 系统可以在原则上验证所有可能的价态组合。
每个碳原子的可能杂化状态:sp、sp²、sp³或未定义。这一选择基于13C 和1H 核磁共振谱中的特征化学位移、化学组成以及分子的不饱和度。
每个碳原子与杂原子的可能相连关系:禁止、必须或未定义。一个典型的挑战示例:δ =
103 ppm 的碳是sp²杂化状态的碳,还是sp³杂化状态但通过单键连接两个氧的碳?
与给定碳原子最近邻的碳原子上可能的氢原子数量(如果可能,从一级1H 核磁共振谱的信号裂分类型中确定)。这一决定可能具有较高风险,因此此类约束应谨慎使用,仅在信号无重叠且裂分类型可以可靠确定的情况下使用(例如甲基共振信号显示明显的单峰、双峰或三重峰)。
允许的最大的键级:1、2 或3。主要挑战涉及与杂原子相邻的碳(例如C(sp²)或O–C(sp³)–O),以及是否存在三键。严格来说,后者只能通过结合红外(IR)和拉曼(Raman)光谱可靠地解决:红外光谱可用于判断是否存在末端–C≡CH 和–C≡N 基团,而中间的–C≡C–基团通常在拉曼光谱中表现为强峰,且该峰可能在红外光谱中不存在。
可能存在于分子中的片段列表:根据化学考虑或通过使用13C 核磁共振谱进行片段搜索得出,片段数据库用于此目的。化学考虑通常源于对已知化合物(特别是具有相同来源和相似光谱的天然产物)核磁共振谱的仔细分析。最重要的官能团(C=O、OH、NH、NH₂、C≡N、C≡C、C≡CH 等)的存在可以通过结合红外和拉曼光谱,并参考核磁共振数据和未知物的分子式来推测。如果未知物是化学反应的产物,则可以根据化学知识推测某些片段的存在。
在给定结构问题中被禁选的片段列表:包括在有机化学中不太可能出现的片段,例如小环中的三键或O–O–O 连接等。此外,还包括在化学中罕见的高度张力亚结构。核磁共振、红外和拉曼光谱也可以为禁止片段的确定提供线索,而公理Xj→Ai 通常是做出特定决定的可靠基础。例如,如果在红外、13C 和1H 光谱中未观察到苯环的特征吸收带,则可以将该基团列入禁止片段列表。通过非常简单的结构约束,通常可以排除大量可能的分子结构。显然,如果基于上述要点做出的至少一个决策不当,则很可能导致无法解析出正确的结构。
1.2.4 结构解析所用信息的特性
如果我们将构成特定分子结构解析的部分公理化理论的所有公理和假设进行概括,则可以总结出以下初始信息的特性,这些特性需要从逻辑上进行分析:
信息的模糊性:例如,在HMBC 谱中,与二维峰(δHi, δCk)相关联的Hi 和Ck 原子之间可能存在2 或3 个键,这种不确定性使得信息具有模糊性。
信息的不完整性:并非所有理论上可能的相关性都会在二维核磁共振(2D NMR)谱中被观察到,因此信息是不完整的。
非标准相关信号(NSCs)的干扰:NSCs 的存在经常导致信息矛盾,增加了结构解析的复杂性。
信息的不确定性:NSCs 的数量及其真实长度(四键、五键还是六键?)未知,且核磁共振谱中的信号重叠会导致模糊的相关性出现,因此信息具有不确定性。
信息的潜在错误性:如果研究者提出了错误的假设,则信息可能是错误的。
信息的主观性:包含在“结构公理”中的信息反映了研究者的观点,因此信息具有主观性,通常基于生物合成或其他化学逻辑的论证。
这些特性表明,分子结构解析不仅依赖于实验数据的客观分析,还需要研究者在逻辑推理和假设验证中保持谨慎,以避免因信息的模糊性、不完整性或主观性而导致错误结论。
二维核磁共振(2D NMR)数据的不完整性通过图1.7 和图1.8 [27] 得以说明,这些图展示了天然产物在COSY 和HMBC 谱中观察到的相关性与理论上可能的相关性之间的数量关系,其中红线表示比率为1 的完全匹配情况。
结合前文所述的信息特性,我们可以理解为什么人类专家在处理复杂结构解析时,往往难以穷尽所有可能的结构假设。这也解释了为什么不同研究者基于相同的实验数据可能得出不同的结构结论,进而导致修订先前报道的化学结构的文献屡见不鲜[18–20]。考虑到结构解析过程中可能累积的多种潜在错误,化学家能够成功处理如此复杂的谱图-结构信息并推导出高度复杂的分子结构,这一能力本身已令人惊叹。
为了帮助化学家更高效、逻辑化地处理初始信息,开发一种能够系统生成和验证所有可能结构假设的计算机程序显得尤为重要。专家系统Structure Elucidator(StrucEluc)正是为此而生,它包含一系列专门设计的软件程序和算法,能够处理模糊、矛盾、不完整、不确定、主观甚至错误的谱图-结构信息。在后续章节中,我们将看到,Structure Elucidator 并非简单的自动化工具,而是一个强大的人类智能放大器,它像引擎一样,从核磁共振光谱数据和特定问题的公理集中推断出所有可能的逻辑推论(即分子结构)。
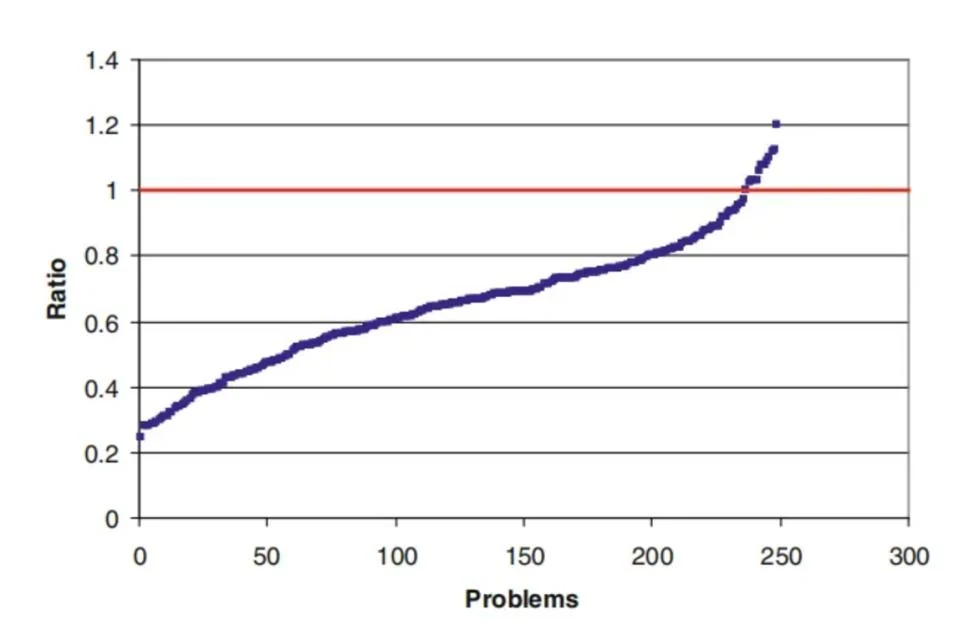
这些天然产物被用作挑战StrucEluc 系统的测试案例。图中问题按照比率升序排列,比率值超过
1 的情况归因于COSY 数据中非标准相关性(NSCs)的存在[26]。
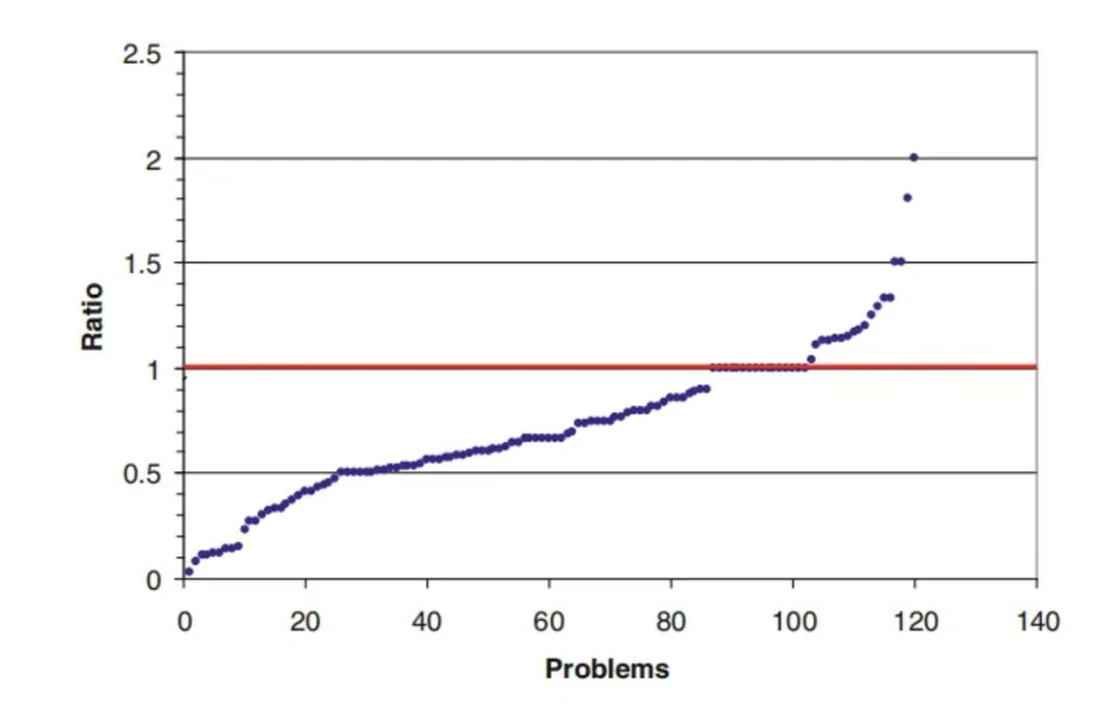
率,这些天然产物被用作挑战StrucEluc 系统的测试案例。图中问题按照比率升序排列,比率值超过1 的情况归因于HMBC 数据中非标准相关性(NSCs)的存在[26]。