1.1 Structure Elucidator专家系统是如何工作的?
摘要
本章首先系统阐述了专家系统Structure Elucidator 的工作流程,该流程包含三个关键环节:候选子结构筛选→分子结构生成→基于核磁数据预测方法的筛选得到最可能结构。随后深入探讨了光谱-结构解析的理论基础,着重解释了用于逻辑推断未知物结构的初始信息的公理化本质。
文中区分了以下三类公理(陈述):第一类公理基于一维核磁(1D NMR)和红外光谱(IR)的特征性信号;第二类公理基于二维核磁数据(HSQC、HMBC、COSY 等)的关联性规则;第三类公理则用于分子结构的组装约束。研究表明,在实际复杂体系的结构解析中,Structure Elucidator 能够有效处理初始数据存在的模糊性、不完整性甚至矛盾性,从而准确推导出目标分子结构。
值得注意的是,这种公理化分析方法不仅构成了计算机辅助结构解析(CASE)的理论基础,同时也为传统有机化合物的结构鉴定提供了重要的方法学支撑。Structure Elucidator的知识库由两大模块组成:一是包含化学键参数、杂化规则等的基础事实数据库;二是整合了各类光谱特征关联规则的公理知识库。此外,系统集成的三种核磁谱预测方法:增量法(基于化学位移逐步修正)、神经网络算法(基于大数据训练模型)以及HOSE 算法(基于球形环境分层组织的预测)。
1.1.1 引言
当研究人员分离出一种未知化合物时,无论是化学反应产物还是从自然界中提取的物质,下一步便是确定其结构。为实现这一目标,通常需要对样品进行质谱(MS)、1H NMR、13C NMR 和红外光谱(IR)等分析。除了传统的人工结构解析方法外,还可以通过搜索相关数据库或文献中的光谱数据进行比对。例如,若通过13C NMR 数据搜索发现未知化合物的光谱与参考光谱完全一致,则可推断未知化合物的结构与参考化合物相同,这一过程称为结构识别(structure identification)。
然而,当通过谱图检索无法确定未知物结构(即无法找到匹配的参考数据或该化合物为新物质)时,就面临结构解析的挑战。虽然数据库谱图检索本身并非易事,但解析新化学物质(如复杂天然产物)的结构通常更为复杂。实践表明,解析复杂有机分子结构需要综合运用多种实验数据,其中核磁共振(NMR)波谱是最有力的工具。目前,1H NMR、13C NMR、
1H-13C HSQC、1H-13C HMBC 和1H-1H COSY 谱是解析复杂有机分子结构的常用手段,尽管在某些情况下无需COSY 数据亦可完成解析。如今,几乎每一篇关于新有机化合物结构解析的出版物都会使用二维核磁共振波谱技术。
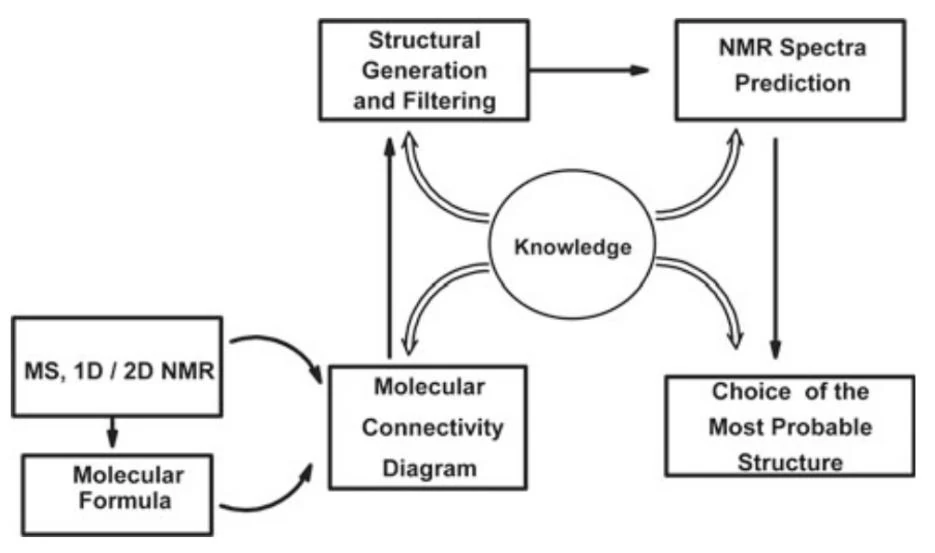
Structure Elucidator[1]专家系统的开发,为化学家提供了一种智能分析工具,能够辅助解析尚未被研究且光谱数据未见于文献或数据库的新有机化合物的结构。为了从光谱数据中推断出正确的结构,专家系统必须在结构解析过程中模拟光谱学家的推理过程。早在20 世纪60 年代末至70 年代初,开发专家系统的开创性工作便已启动[2–6]。图1.1 展示了结构解析过程中人工推理的主要步骤流程图。
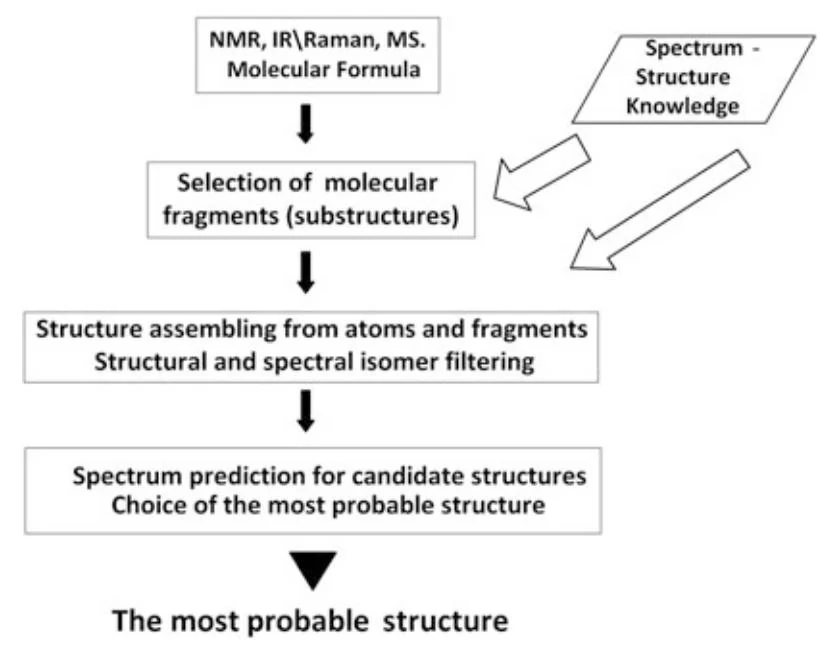
在初始分析阶段,质谱被用于确定目标化合物的分子式。这一步骤至关重要,因为分子式为后续的结构解析提供了关键的限制条件,显著减少了可能异构体的数量。若分子式未知,候选结构的数量将趋于无限,导致结构解析难以进行。当前,高分辨质谱(HRMS)是确定分子式的首选方法,其能够提供精确的分子质量信息,从而推导出准确的分子式。
在分子式确定的基础上,专家基于谱图-结构相关性的知识,对目标化合物的其他光谱(如核磁共振谱、红外光谱等)进行深入分析。通过这种分析,可以初步推测出一组可能的子结构(分子片段)。这些片段的存在性基于谱图特征与分子式的组成得以验证。随后,专家尝试将这些片段组合成完整的分子结构,同时利用分子式中未被片段占据的“自由”原子进行补充。这一过程被称为“人工结构解析。
在人工结构解析过程中,专家充分运用其掌握的谱图特征知识,确保所提出的分子结构与实验数据完全吻合。例如,若分子式包含两个氧原子,且在13C NMR 谱中观察到205 ppm的单峰,专家可能会优先考虑包含酮基的结构,而排除所有包含酯基的可能性。这种基于光谱特征的结构筛选过程,实质上是一种人工的“谱图结构过滤”(spectral structure filtering)。
此外,专家还需避免提出与化学规则相矛盾的结构。例如,包含三键的三元环或四元环结构,或违反Bredt 规则的结构,通常会被排除在候选结构列表之外。这种基于化学常识的筛选过程,相当于对假设分子结构进行手动化学规则过滤。然而,即使目标化合物的分子量并不大,人工结构解析过程中需要考虑的候选结构数量仍然非常庞大。由于人工分析的局限性,无法确保所有可能的结构都被考虑到。
当专家筛选出一组概率均等的候选结构,且无法根据其特征光谱信号明确确定首选结构时,便需要进行更精确的结构评估。此时,对所有候选结构进行全谱预测将提供关键判别依据。计算得到的光谱不仅包含特定光谱区间的特征信号(例如,NMR 化学位移、红外频率),这些信号反映了分子中存在的结构基团特征,还包括其他光谱特征的近似值(例如,指纹区红外频率),这些特征预计会在相应结构的光谱中出现。值得注意的是,现代量子力学(QM)方法在NMR 谱计算中表现出极高的准确性,即使是对具有前所未见骨架的分子,也能精确预测其化学位移。通过比较计算谱与实验谱,与实验数据最吻合的结构可被认定为最可能的未知结构。
上述结构解析流程被作为开发所有基于光谱数据阐明分子结构的专家系统的基础[6,8,9]。乍看之下,这种方法似乎简单直观,但使用数学算法和模拟人类专家推理的软件来实现这一过程却极具挑战性和复杂性。为了形式化结构解析过程的各个阶段,研究人员开发了基于数学逻辑、图论和组合分析的算法。特别是在结构生成算法的开发上,研究人员投入了大量精力,以模拟原子和片段的手工组装过程。结构生成器(structure generator)被认为是任何专家系统的核心组件,其性能最终决定了专家系统的整体能力。
结构生成器是一种能够根据给定分子式及结构约束条件,系统生成所有可能异构体结构的程序(无任何遗漏)。
从理论层面看,分子结构解析可仅通过结构生成与结构过滤两步完成,无需依赖片段预选阶段。形象而言,专家系统如同一位精雕细琢的艺术家,通过逐步剔除冗余信息,最终构建出精确的分子模型。以下案例将具体阐释这一流程。
假设某未知化合物经高分辨质谱(HRMS)测定分子式为C6H10O2,其红外光谱(图1.2)基于特征吸收峰(如频率、强度及半高带宽)揭示了官能团信息。经对照参考数据[7,10]分析,确认该分子不含羟基(—OH)或乙烯基(3,100~4,000 cm-1 区间无特征吸收峰,3,000~3,100cm-1 无双峰信号)。然而,烯烃双键(1660 cm-1)、酯羰基(1730 cm-1)及甲基(1380 cm-1)的特征振动峰表明这些基团明确存在。基于上述光谱约束,需筛选出同时满足官能团存在性与排除条件的结构异构体。对于C6H10O2 这一分子式,系统计算显示其潜在结构异构体数量达4,869 个,这一数值可通过现有结构生成器[9]精确得出。
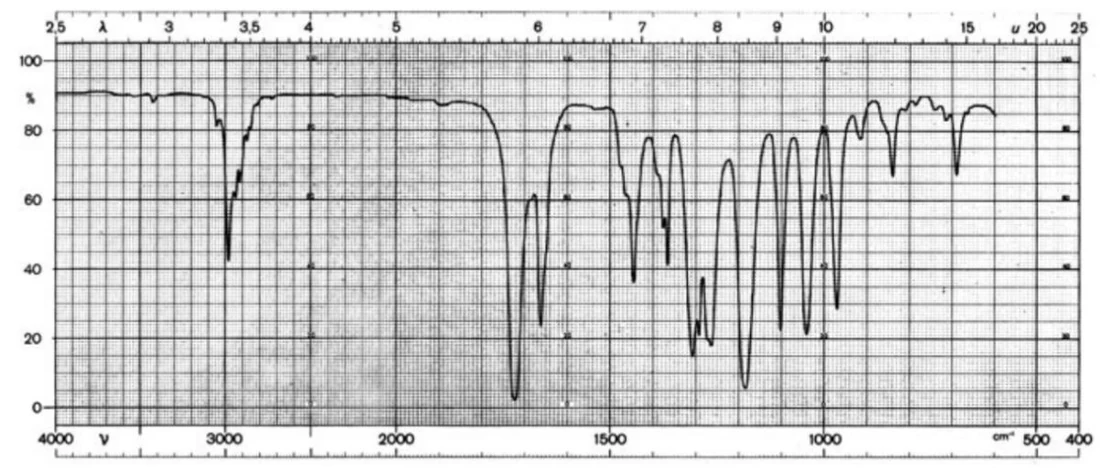
基于红外光谱信息对4,869 个同分异构体进行逐步筛选,最终得到以下结果:初始结构数:4,869 →排除含O-H 基团结构:1,719 →保留含C=O 基团结构:384 →保留含C=C基团结构:151 →保留含CH3 基团结构:147 →保留含O-C=O 基团结构:26 →排除含C=CH2 基团结构:10。
通过直接排除含OH 基团的结构,候选结构数量缩减至原始数量的约三分之一。进一步添加光谱约束条件后,最终仅剩10 个候选结构(见图1.3)。值得注意的是,通过应用红外光谱推导的约束条件,99.8%的可能异构体被排除,潜在候选结构数量从4,869 个大幅减少至10 个。
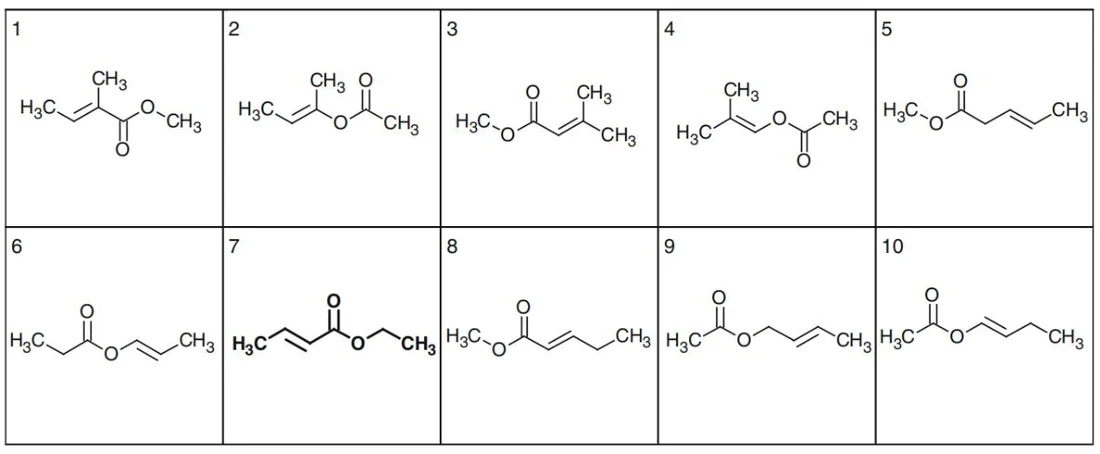
选出的剩余候选结构。
从光谱数据中推导出的一组结构异构体被称为问题的解决方案。若解集中包含真实结构,则称为有效解;否则称为无效解。
设N 为给定分子式对应的理论可能异构体数,k 为符合光谱数据约束条件的结构数,I为从光谱(或一组光谱)中提取的结构信息量。根据文献[9],结构信息量可表示为:
I = log₂N −log₂k = log₂(N/k)
从实验中提取的总结构信息的比例μ可定义为:
μ = (log₂N −log₂k) / log₂N = 1 −log₂k / log₂N以本例为例,μ = 0.73,表明红外光谱携带了总结构信息的四分之三。因此,为了从十个候选结构中明确选择正确结构(图1.3),还需提取几乎剩余四分之一的总结构信息。从这一角度看,从实验数据中额外提取的结构信息对实现明确的结构解析具有重要价值。
值得注意的是,剩余的十个结构非常相似,仅凭红外光谱的特征信号难以直接区分正确结构。为此,进一步分析了化合物的1H NMR 谱(如图1.4 所示)。
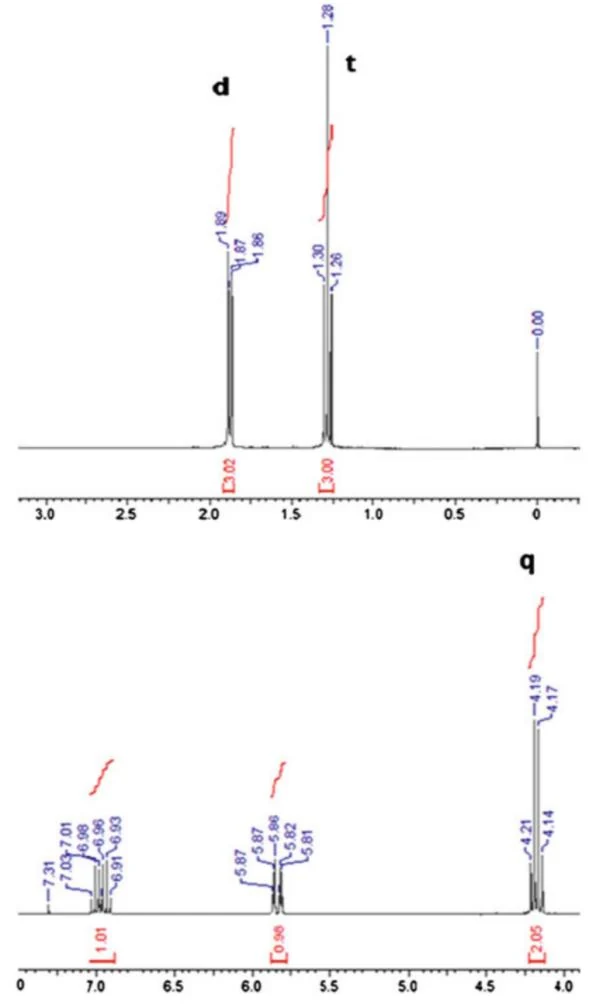
在1H NMR 谱的1-4.2 ppm 区域观察到的三个不同多重峰信号,为O-CH2-CH3 片段的存在提供了明确证据。除结构#7 外,其他所有异构体均不包含这一片段。因此,通过引入这一附加约束条件,我们可以直接应用CASE(计算机辅助结构解析)策略完成未知物的结构解析。结果表明,该策略在此案例中取得了有效解。这种方法是切实可行的,在普通PC 处理器上运行StrucEluc 软件仅需0.4 秒即可完成结构生成(即在红外光谱约束条件下执行)。
然而,这种直接的方法仅适用于分子式较为简单的情况(即重原子数不超过15-20 个)。随着分子式中重原子数及不饱和度值的增加,异构体数量及其生成时间几乎呈指数级增长,从而导致所谓的组合爆炸问题。例如,分子式C18H34O 可生成870,280,931 个异构体,其中大部分为稳定分子。在标准PC 上,生成所有可能异构体(不保存至磁盘)的处理器时间为1 小时25 分钟。
图1.5 展示了一系列中等大小化合物的结构及其计算得到的同分异构体数量[11]。
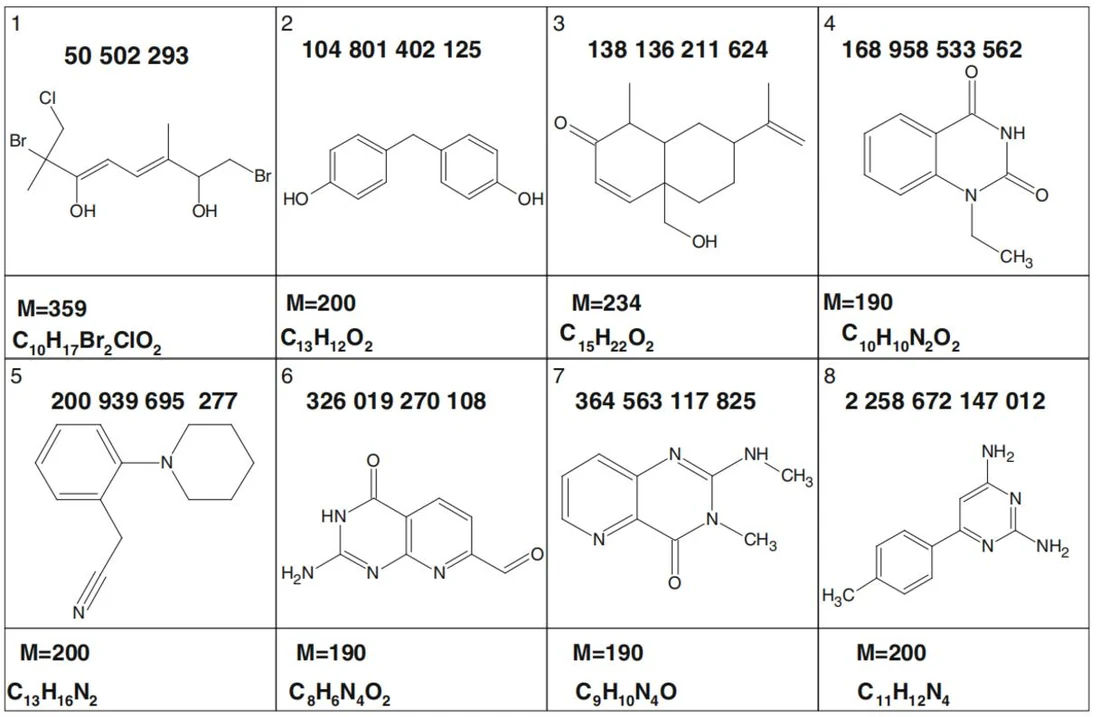
图1.5 表明,即便结构极其简单的化合物也可能存在数亿至数万亿的同分异构体。以分子式C₁₀H₁₇Br₂ClO₂为例,其理论同分异构体数量超过5,000 万,初步分析显示其中4,000 万以上可能为稳定结构。需特别指出的是,CAS 物质数据库目前仅收录9,000 万种已知化合物,且其中6,700 万种为可商业获取的实体化合物[12]。
分子式中重原子(如Br、Cl 等非碳氢原子)的数量决定了问题的维度。降低此维度的唯一途径是引入“宏观原子”分子片段——这类片段能够整合多个重原子并形成离散的结构单元,从而有效缩减问题规模。
乍看之下,利用具有特征光谱信号的大分子片段进行结构解析看似是理想策略。然而这种方法面临一个根本性难题:由于化学组合的复杂性(即所谓的"组合爆炸"现象),我们无法为所有可能的大分子片段建立完整的谱图-结构对应数据库——这类片段的数量呈指数级增长,根本无法穷尽。因此,要实现真实分子的结构生成,必须满足特定的条件。
结构解析的成功率本质上取决于对骨架原子施加的约束条件数量及其严格程度。
约束条件可通过两种形式施加:
1.引入结构片段(子结构)——这些片段由特定化学键连接的原子组成,化学键的多重性(如单键、双键、三键)直接影响片段的定义;
2.基于二维核磁共振谱(2D NMR)分析结果——通过实验数据(如COSY、HMBC)提取结构信息。
在这种情况下,会使用从COSY 数据中检测到的明确片段(Strict fragments),以及包含由HMBC 相关信号所确定连接性的骨架原子的模糊片段(fuzzy fragments)(详见第2 章)。明确片段与模糊片段的合理组合通常能够在合理的时间内完成结构生成。然而,正如后续章节(第三部分)所述,仅使用HMBC 数据获得的模糊片段,也能成功实现结构生成,并解释大多数有机大分子的结构。
在CASE 系统的发展历程中,多个研究团队花费数十年时间,才开发出基于片段的有效结构解析方法[8,9,13-15]。这充分表明,开发CASE 系统所面临的挑战是何等复杂。
1.1.2 Structure Elucidator 的工作流程图
Structure Elucidator 的设计旨在允许用户利用多种约束条件,这些约束条件可来源于1D和2D NMR、MS、IR/Raman 和UV 光谱,以及其他结构信息来源(如样品来源、化学知识等)。图1.6 展示了Structure Elucidator 专家系统的简化原理流程图。
用于结构解析的核磁共振实验数据包括:
13C 和1H NMR 谱;
1H - 13C HMBC 谱(如有1H - 15N HMBC 数据也可提供);
1H - 1H COSY 谱;
其他基于2D NMR 技术获得的谱图。
首先,通过高分辨质谱(HRMS)确定未知物的精确分子质量和分子式。在结构解析的最后阶段,可使用完整的MS 数据验证最可信的候选结构。此外,如果红外/拉曼和紫外光谱能够提供某些官能团存在或不存在的信息,这些数据也可用于辅助结构解析。