01 引言
脒是一种具有多种用途的含氮结构基团[1,2]。特别是 N-酰基脒结构,作为一种特殊的超碱官能团,存在于具有生物活性的天然产物和药物分子中[3–6],如天然产物 janoxepin、cinereain 与西地那非(sildenafil)。目前对 N-酰基脒类化合物的研究主要集中在其生物活性与独特骨架上。
为了继续寻找新颖生物碱[3–8]作为分子探针或活性分子,研究团队对非洲马铃果(Voacanga africana)进行了研究,从中分离得到化合物 voafriamidine(图 1),它是一个 6/5/8/6/5 五环的单萜吲哚生物碱,具有一个独特的 2,4-二氮杂三环-[6,5,1¹,⁸,0³,⁷] 十四烷母核,包含一个特别缺氢的 N-酰基脒结构,可能以 perivin 作为前体经生物合成得到。
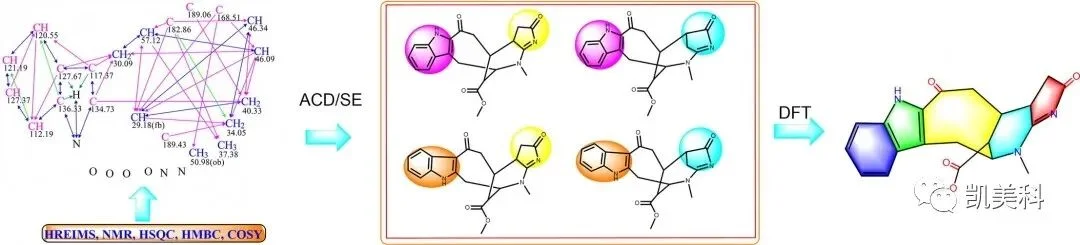 图 1 化合物 voafriamidine(1)的化学结构
N-酰基脒类化合物是一类含有高效共轭作用且特别缺氢的双功能天然产物,在阐明其结构时非常容易发生异构化[9]和错误的归属[10]。因此,对包含大量杂原子、缺乏质子的稠环系统新颖结构进行结构解析,仍然是一项具有挑战性的工作。
计算机辅助结构解析(CASE)专家系统是近年来得到发展的、具有严格逻辑算法的软件工具,可协助进行结构解析与结构纠正[11]。Structure Elucidator(简称 SE)是一款功能强大的 CASE 专家系统软件,它能够依据化学规则与化学常识,从不精确的谱图信息中自动、快速地识别出最可能的结构[12,13]。然而在某些情况下,SE 也存在一定的局限性:由于其基于经验算法进行 NMR 预测,很难在高度相似的结构中辨别出正确结构。因此,为避免错误的结构解析,需要更高精度的、基于理论计算的方法来预测 NMR 与手性,以补充 SE 的解析能力。已有大量研究报道了基于原子轨道(GIAO)方法的密度泛函理论(DFT)计算在化学位移预测与空间构型分析中的应用[14];作为一种高精度的量子力学(QM)计算方法,它可从给定的同分异构体中,通过特定的预测值区分出正确结构[15]。将 SE 与 DFT 方法结合辅助结构解析,可以提高工作效率与准确性。
本文报道了联合应用 SE、DFT 核磁共振数据计算与 ECD 分析的方法来表征化合物 voafriamidine(1),通过高分辨电喷雾质谱与 NMR 信息,对 N-酰基脒骨架化合物进行从头解析。
02 结果与讨论
2.1 平面结构的推断
根据 voafriamidine(1)的 13C NMR 谱数据(表 1)与高分辨质谱数据(m/z 402.1430 [M+Na]⁺,计算值 402.1424),推断其分子式为 C21H21N3O4,不饱和度为 13。红外光谱提示该化合物含有一个氨基(3424 cm⁻¹)、三个羰基(1728、1647、1573 cm⁻¹)与一个芳香环(1448、1413 cm⁻¹)。其在 205 nm 与 244 nm 处的紫外最大吸收值与已知化合物 1H-吲哚[16]相似。
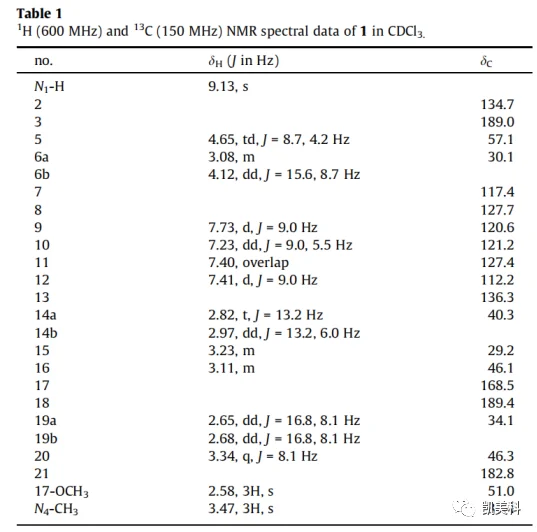 表 1 化合物 1 的 1H (600 MHz) 与 13C (150 MHz) NMR 数据(CDCl3)
化合物 1 的碳谱显示有 21 个碳信号,包括 1 个酯羰基(δC 168.5)、1 个甲氧基(δC 51.0)、1 个 N-甲基信号(δC 37.4)、3 个低场 sp² 季碳信号(δC 189.4、189.0 与 182.8)和 7 个 sp³ 碳信号;其余 8 个 sp² 碳信号及氢谱数据代表 2,3-二取代 1H-吲哚发色团(图 1 中的 A、B 环):δC 134.7 (s, C-2)、117.4 (s, C-7)、127.7 (s, C-8)、120.6 (d, C-9)、121.2 (d, C-10)、127.4 (d, C-11)、112.2 (d, C-12) 与 136.3 (s, C-13),对应的 δH 9.13 (1H, s, N-H)、7.73 (1H, d, J = 9.0 Hz, H-9)、7.41 (1H, dd, J = 9.0 Hz, H-12)、7.40 (1H, overlap, H-11) 与 7.23 (1H, dd, J = 9.0, 5.5 Hz, H-10)。
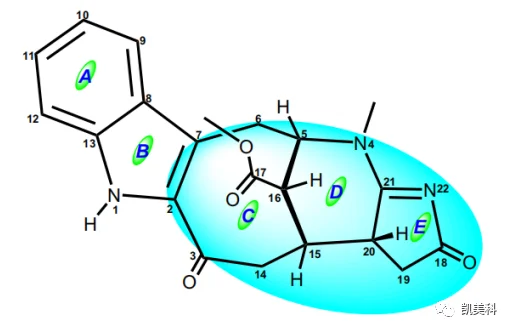 图 2 化合物 1 的 1H–1H COSY 与关键 HMBC 相关信号
在 1H–1H COSY 谱中,δH 3.08、4.12 (H-6) 与 4.65 (H-5) 相关,δH 4.65 (H-5) 与 3.11 (H-16) 相关,δH 3.11 (H-16) 与 3.23 (H-15) 相关,δH 3.23 (H-15) 与 2.82、2.97 (H-14) 相关;以及 δH 3.23 (H-15) 与 3.34 (H-20) 相关,δH 3.34 (H-20) 与 2.65、2.68 (H-19) 相关,分别提示片段 C6–C5–C16–C15–C14 与片段 C15–C20–C19 的存在(图 2)。
在 HMBC 谱中,δH 3.08、4.12 (H-6) 与 δC 134.7 (C-2)、117.4 (C-7)、127.7 (C-8) 相关,δH 2.82、2.97 (H-14) 与 δC 134.7 (C-2) 和 189.0 (s) 相关(图 2),假定这是一个共轭酮碳与 C-3 位吲哚环相连,可能引起紫外-可见光谱中 314 nm 处的红移(见 Supporting Information 图 S4)。据以上数据推断结构可能为八元烯酮环 C。此外,δH 3.23 (H-15) 与 3.11 (H-16) 与 δC 168.5 (s) 相关,δH 2.58 (3H, s) 与 δC 168.5 (s) 相关,故酯羰基(δC 168.5)归属到 C-17,提示甲羧基的存在。另外,δH 3.47 (N-CH3) 与 δC 57.1 (C-5) 和 182.8 (s) 相关,δH 4.65 (H-5)、3.23 (H-15)、2.65、2.68 (H-19) 与 3.34 (H-20) 与 δC 182.8 (s) 相关,这些信号表明 δC 182.8 的碳信号与 N-4 和 C-20 相连,进而形成哌啶环 D。C/D 环共享 C15–C16–C5 桥结构,从 HMBC 的这些相关信号得到印证——δH 3.11 (H-16) 与 δC 30.1 (C-6)、40.3 (C-14)、46.3 (C-20) 相关,δH 2.82、2.97 (H-14) 与 δC 46.3 (C-20) 相关。为满足分子式,除剩余的一个季碳(189.4)外,还需一个氮原子、一个氧原子与 3 个不饱和度。最后,根据 HMBC 相关信号——δH 2.65、2.68 (H-19) 与 δC 189.4 (s) 相关,推断存在一个吡咯酮环 E。至此,化合物 1 的平面结构暂定为一个新颖的 6/5/8/6/5 五环单萜吲哚。
经与数据库比对发现,与单环或开链结构部分不同,化合物 1 含有少见的由两个烷基环构成的 N-酰基脒结构单元(N4–C21–N22–C18)。化合物 1 中的 N-酰基脒片段具有两个叔氮和两个季碳,HMBC 谱的相关信号不足以解释该结构片段,因此需要更多证据来确证该结构。
2.2 SE 计算机辅助结构解析
由于未能获得化合物 1 的单晶结构,研究团队采用 SE 软件的 CASE 算法来解决上述问题。SE 可根据已知的分子式与 NMR 谱信息,生成所有可能的同分异构体,不仅能避免交叉峰信号的归属错误,还能依据计算的偏差值识别出正确的结构[19]。
将化合物 1 的 1D 与 2D NMR 谱信息和质谱(分子式)导入 SE。根据 NMR 谱图中的典型数据与特征性耦合常数,在软件进行结构生成的过程中人为限制了 1H-吲哚的结构部分。利用这套数据,SE 专家系统自动生成了编辑过的分子连接图(molecular connectivity diagram,MCD,图 3)。
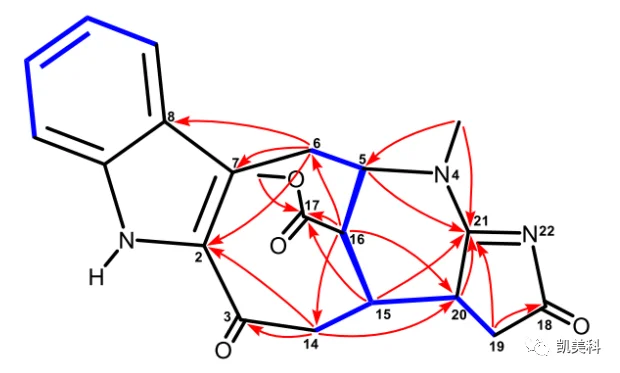 图 3 编辑过的分子连接图(MCD)
针对编辑好的 MCD 图,对软件生成结构的选项进行设置,禁止杂原子之间形成化学键;由于在 COSY 与 HMBC 谱中未发现矛盾之处,因此执行 “strict structure generation”(严格结构生成)选项。在结构生成过程中,软件会进行碳谱化学位移预测,平均偏差 dI > 4 ppm 的结构会被拒绝保留。
首先,SE 根据分子式的元素组成与 MCD 图的连接关系,生成了所有可能的结构异构体(403,406 个分子);随后剔除碳谱化学位移平均偏差大于 4 ppm 或最大偏差大于 20 ppm 的结构,剩余 28 个候选结构。再通过 SE 的三种 NMR 预测算法(HOSE 算法 dA、神经网络算法 dN、加和算法 dI)对候选结构进行碳谱化学位移计算[21],并按实验值与预测值的平均偏差 dA(13C) 进行排序(详见原文 Supporting Information)。
通常而言,SE 计算得到的正确结构,其平均偏差 dn(n = A, N, I)一般小于 3 ppm,或排名第一位,或至少位于靠前位置。
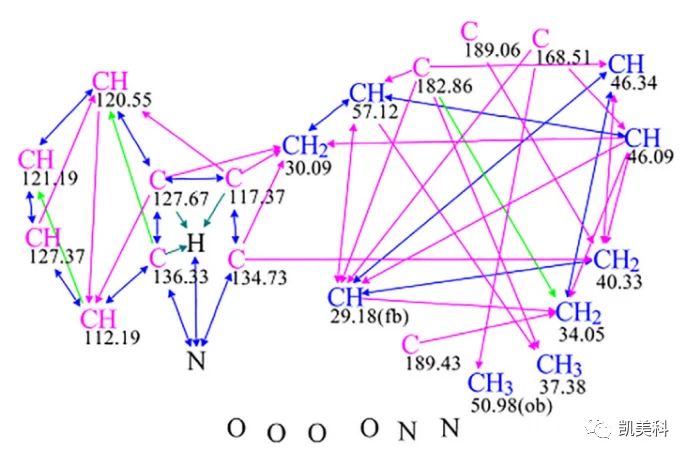 图 4 SE 软件计算排名前四的分子结构
从图 4 可见,最终确定的结构(图 1)排名第一,其三个碳谱化学位移偏差值分别为 dA = 2.466、dN = 2.654 与 dI = 2.255。值得注意的是,排名前四的结构(图 4)平均偏差 dn 均小于 3 ppm,且彼此的平均偏差与最大偏差非常接近,因此很难仅凭该计算结果断定结构 1 即为正确结构,还需对这 4 个结构作进一步分析。
2.3 量子化学计算验证
化合物 1 的 ROESY 谱显示,δH 2.68 (H-19b)/3.34 (H-20)、3.34 (H-20)/3.11 (H-16)、3.11 (H-16)/4.65 (H-5)、4.65 (H-5)/3.47 (N-CH3)、3.47 (N-CH3)/4.12 (H-6b) 以及 4.12 (H-6b)/7.73 (H-9) 之间存在较强相关,故 H-19b、H-20、H-16、H-5、N-CH3、H-6b 与 H-9 位于同一侧;而 δH 2.65 (H-19a)/2.97 (H-14b) 与 2.97 (H-14b)/3.23 (H-15) 具有 NOE 相关,故 H-19a、H-14b 与 H-15 位于另一侧(图 5)。
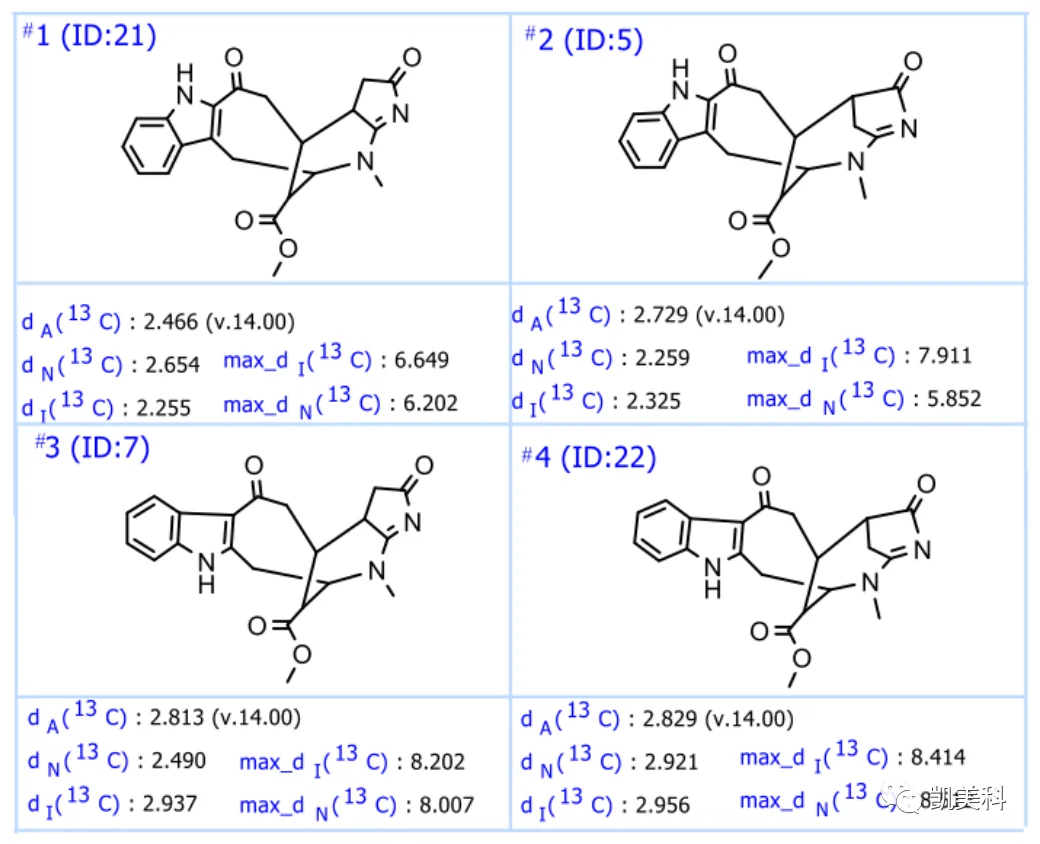 图 5 化合物 1 的 ROESY 相关
然而,在软件预测的结构 #2、#3 与 #4 中,并未完全发现这些相关性(见原文 Supporting Information 图 S11–S13),因此这三个结构无需进一步分析。此外,结构 #1 的 13C NMR 理论计算值(见 Supporting Information)提供了坚实证据:该理论计算采用 GIAO 方法,在 MPW1PW91/6-311+G(2d,p) 水平下进行,化合物先在 B3LYP/6-31G(d) 水平下进行几何优化[23,24]。最后通过线性回归分析,结构 #1 的计算数据与实验 13C NMR 数据的相关系数 R² 为 0.9995(图 6),平均绝对偏差(MAD)为 1.02(见 Supporting Information 表 S1)。
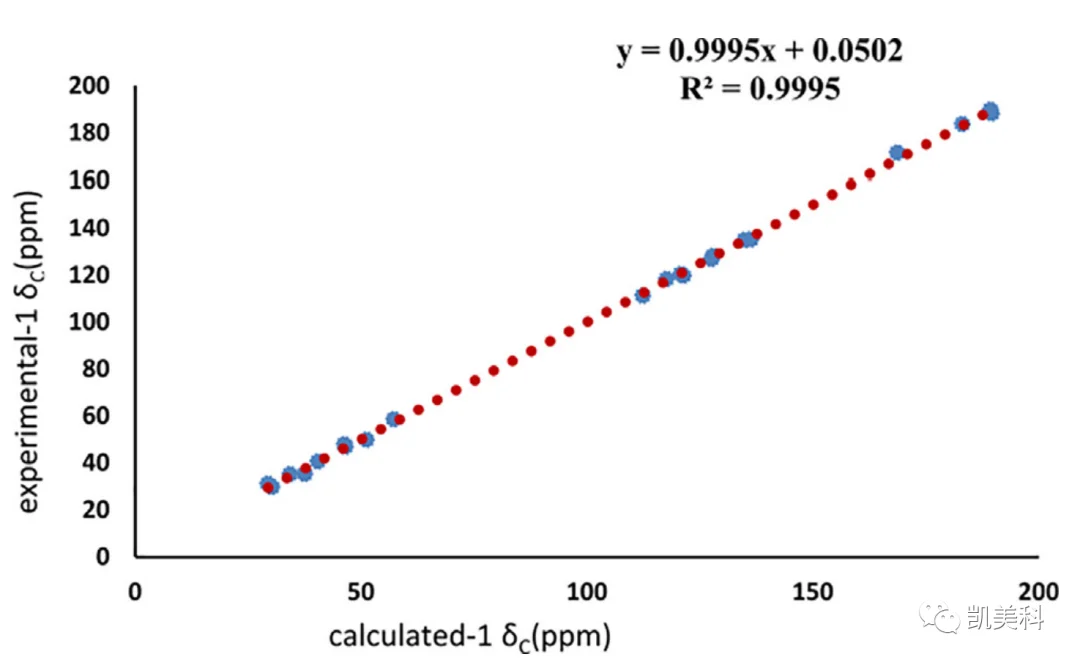 图 6 结构 #1 的 ¹³C NMR 计算数据与实验数据的相关性分析
2.4 绝对构型的确定
综合以上分析,结合生物合成途径(图 7),可将化合物 1 的立体构型归为 5S*、15S*、16S*、20R* 或 5R*、15R*、16R*、20S*。为确定其绝对构型,研究团队应用可靠的计算 ECD 方法,使用 PCM 模型在 B3LYP/6-311G(d,p) 水平下对甲醇中的化合物进行理论计算。如图 8 所示,对映体 (5S, 15S, 16S, 20R) 的计算 ECD 曲线与实验谱基本一致,而另一对映体 (5R, 15R, 16R, 20S) 的 ECD 曲线与实验谱基本相反。
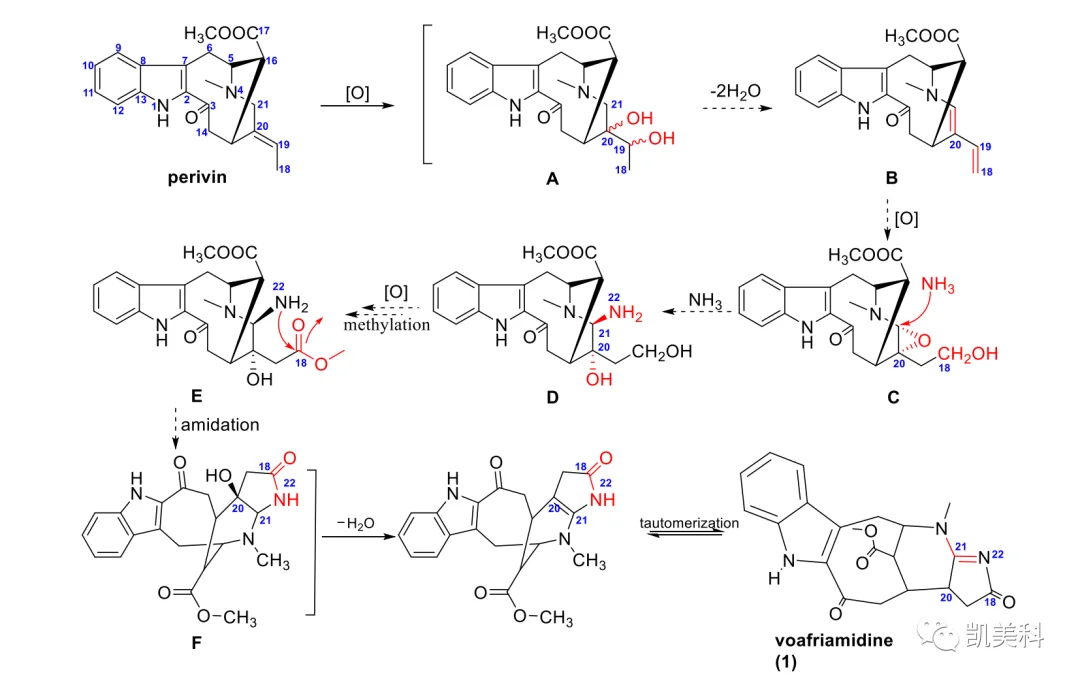 图 7 / Scheme 1 推测的化合物 1 生物合成途径(perivin → voafriamidine)
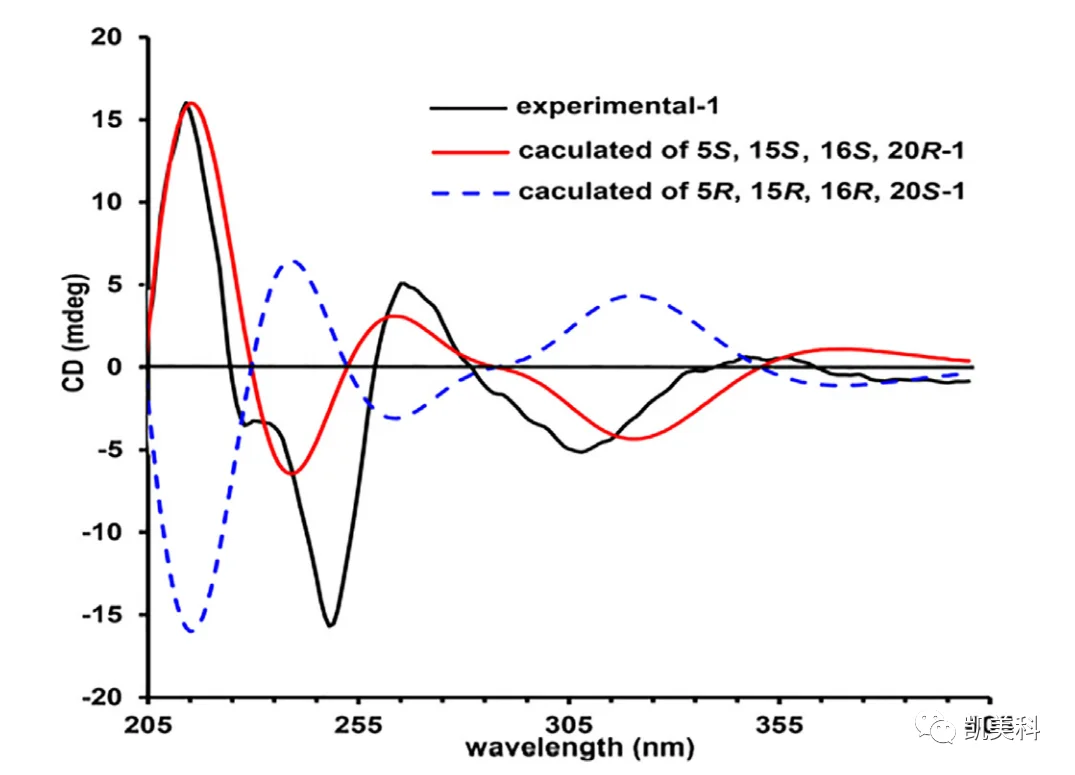 图 8 化合物 1 的实验 ECD 谱与计算 ECD 谱
如 Scheme 1 所示,化合物 1 的生物合成可追溯至共同前体 perivin[27](本实验中也分离得到)。perivin 的 C-19/20 位原子可发生环氧化生成邻二醇中间体 A;中间体 A 脱水生成二烯烃中间体 B;C-18 位与 C-20/21 位进一步氧化,C-21 位发生胺基化产生关键中间体 D,随后在氧化的 C-18 与 N-22 之间发生胺化形成中间体 F;最后 F 经脱水与互变异构化,得到 voafriamidine(1)。
2.5 抗菌活性
非洲马铃果传统上用于治疗微生物感染[28]。研究团队测试了化合物 1 对 6 株细菌的抗菌活性,结果表明其对伤寒沙门氏菌具有微弱抗菌活性,最低抑菌浓度(MIC)为 50 mg/mL(见 Supporting Information 表 S3)。
03 小结
voafriamidine 是一个骨架全新的、含罕见缺氢 N-酰基脒结构的五环单萜吲哚生物碱。其结构解析难点在于缺乏季碳与氮原子的常规 NMR 相关信号、且 N-酰基脒片段极易异构化与错误归属。本案例展示了一种典型的工作流:以 SE 的 CASE 算法快速生成候选结构并排序,再以 DFT(GIAO)量子化学计算与 ECD 理论计算进行高精度验证,最终在缺乏单晶的条件下完成了复杂结构的从头解析与绝对构型确定。这一组合方法对类似"高杂原子、贫质子、易异构"的天然产物结构解析具有重要的借鉴意义。
凯美科提示:Structure Elucidator 可与量子化学计算、ECD 等验证手段协同,应对传统方法难以处理的复杂未知物结构解析。如您所在团队有疑难结构解析需求,欢迎与我们联系,了解软件产品方案与技术合作。
参考资料
- 原文:Rapid and unambiguous assignment of proton-deficient N-acyl amidine indole alkaloid by a combination of calculation methods. Tetrahedron Letters(罗晓东团队,中国科学院昆明植物研究所).
- 本文由凯美科整理翻译,原文发布于微信公众号「凯美科」(2021-03-12)。
- 关键技术:Structure Elucidator(CASE)、DFT/GIAO 化学位移计算、ECD 理论计算、ROESY 立体构型分析。