01 背景:早期发现阶段的庞大数据量
在药物研发的早期发现阶段,科研人员合成系列化合物供项目团队研究。这些分子先经纯化,再进行质控测试,然后注册到小分子化合物管理系统。质控测试使用多种谱学技术(如 LC-MS/MS、1D-NMR、2D-NMR 等),以确保化合物纯度与结构正确。这一流程通常需要快速完成。
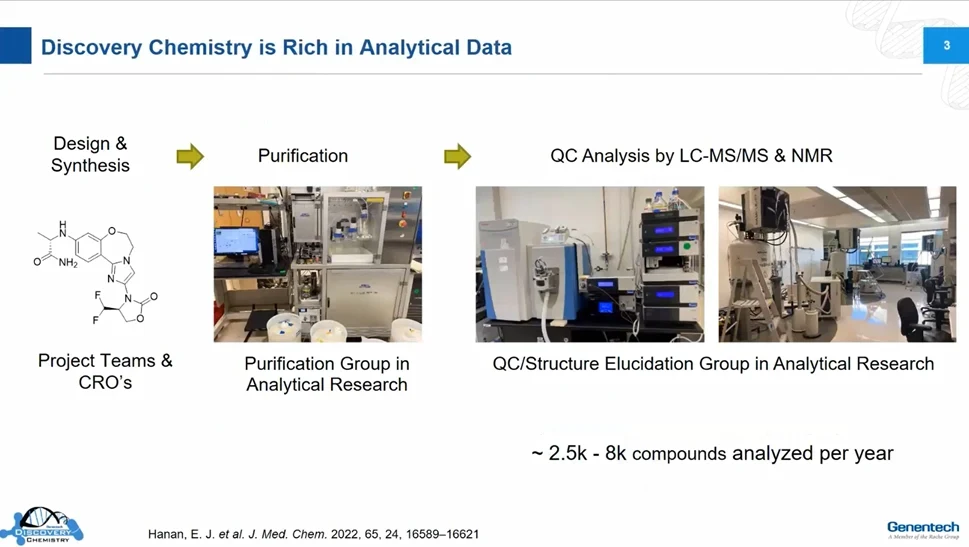 仅需活性与药代评价的化合物:约需 2 mg 样品、周期约 1 天,每年约 2 500–8 000 个;需开展动物实验的化合物:约需 50 mg 样品、周期约 2 周,每年约 60 个
Genentech 开展合作有两点核心诉求:一是最大限度利用已有数据,将药物分子尽快推进到后期开发阶段,同时减少化合物的消耗;二是从早期阶段积累的海量数据中挖掘有用信息,为后续研发提供线索。因此,如何准确获取、管理这些数据并从中获得知识,变得尤为重要。
02 数据流:从仪器到知识库的自动闭环
为将分析数据知识化,双方设计的数据流工作流程如下:
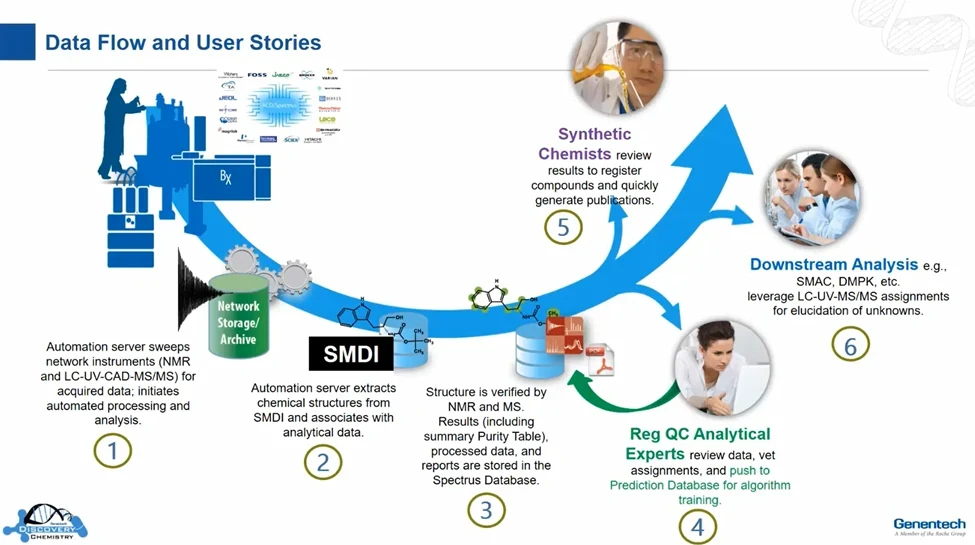 ACD 方案的自动化数据流:仪器数据自动入库,并与内部注册系统的结构信息整合
- 自动采集:自动化服务器(Automation Server)自动扫描分析仪器数据(包括 NMR 与 LC-UV-CAD-MS/MS),将其导入 ACD 数据库。
- 结构关联:服务器同时从 Genentech 内部小分子数据与信息系统 SMDI 中获取化合物结构等信息,与分析数据整合。因此谱图数据库中包含结构、化学家姓名、项目名称等字段,便于检索。
- 结构验证:科研人员在数据库中进行结构验证,将化合物最初提供的结构以及该数据相关的其他可能结构一并存入数据库;同时将 LC-MS 测得的化合物纯度与报告导入数据库。
- 杂质信息沉淀:QC 分析团队的科研人员定期检查这些报告,确保样品中有关物质的杂质信息及含量被准确记录,供下游参考——这使负责 API 稳定性杂质解析的科研人员、以及 DMPK 部门研究 API 代谢产物的同事工作更高效。
- 对外输出:合成化学家拥有工艺流程的全部知识产权,在撰写专利或出版物时常需公布所有的 NMR 与高分辨质谱数据,因此能否按项目、以所需格式一次性获取全部信息十分关键。
03 三类角色的差异化需求
由于需要与数据库互动的团队不同,系统在构建时必须兼顾多方意见:
| 角色 | 核心诉求 |
|---|
| 合成化学家 | 书写报告时并不需要全部细节信息,例如 NMR 的多重峰分析结果不必全部展示 |
|---|
| 负责数据库的分析化学家 | 自动数据处理至关重要——系统应能自动完成校正、峰识别与峰面积计算等操作,提供准确结果并提升效率 |
|---|
| 下游分析化学家 | 后期开发阶段需要与分子特定部分高度相关的 Markush 结构表达方式,例如在代谢物研究中,将额外的氧原子标注在分子的特定片段上,而非指定某个确定结构 |
|---|
04 用户界面:可定制的多视图检索
数据库用户界面提供了多种数据查看方式与定制能力:
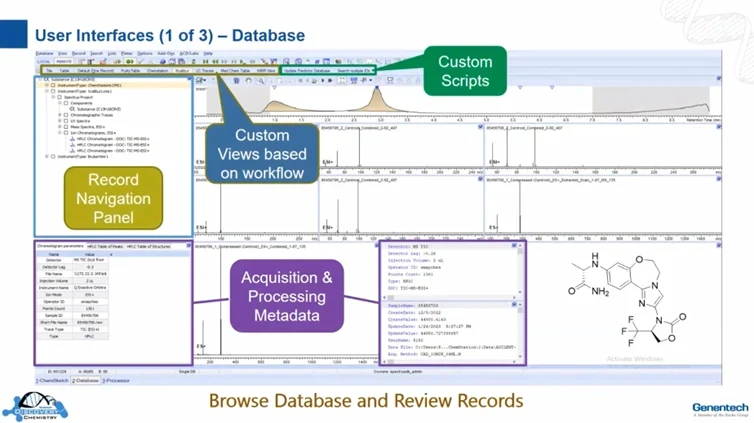 ACD 数据库界面:以分子为中心的记录导航面板、采集与处理元数据、按工作流的定制视图与定制脚本
- Record Navigation Panel:以分子为中心的记录导航面板。
- Acquisition & Processing Metadata:包含 SMDI 编号、项目信息、化学家等元数据。
- Custom Views based on workflow:按工作流定义的定制视图,贴合不同岗位的数据查看习惯。
- Custom Scripts:定制脚本,可将结构解析结果回写到 NMR 预测数据库,持续提升预测准确度。
按业务流程定制的脚本与搜索功能对科研人员尤为关键。下图左侧显示:化学家可用自己的姓名加特定时间段,检索该期间注册的所有分子与分析数据;右上对话框支持录入 G 编号与 SMID 编号快速取数;右下则展示了结构解析人员可把特定数据推送到 NMR 预测数据库中。
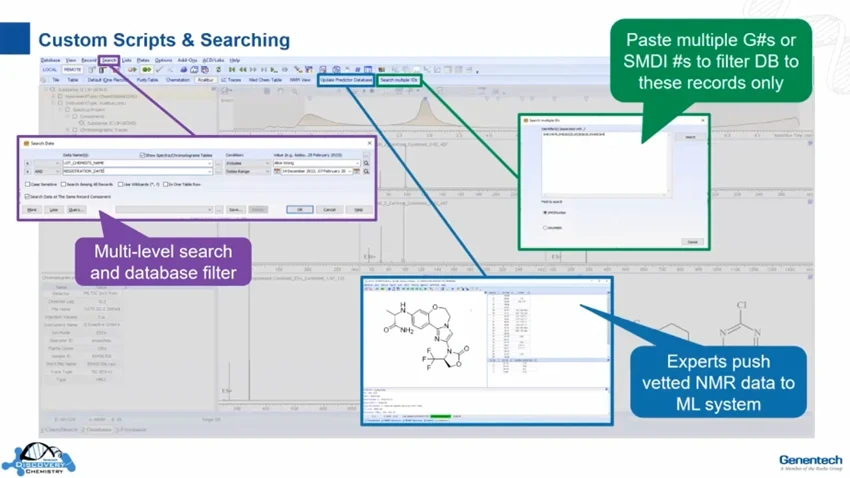 结合化学家、时间段与编号的定制检索,以及向 NMR 预测数据库回填数据的入口
05 数据处理与检索能力
数据库集成的谱图处理软件(Spectrus Processor)界面支持:
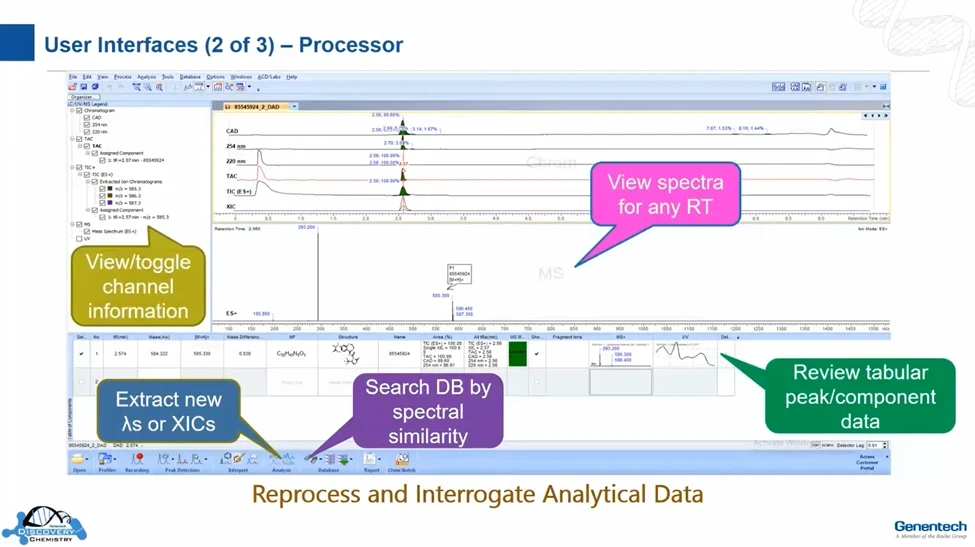 Spectrus Processor 界面:通道信息切换、谱图相似度检索、表格化峰/组分数据与波长/XIC 提取
- View / toggle channel information:勾选左侧导航选项,右侧即时显示或切换不同类型谱图。
- Search DB by spectral similarity:按谱图相似度检索数据库。
- Review tabular peak / component data:以表格方式查看不同化合物的 UV、MS、MS/MS 等数据。
- Extract new λs or XICs:提取新的检测波长或提取离子流色谱图。
在集成的 ChemSketch 画图界面中,可以指定数据库进行化合物结构检索或子结构检索,从而获取与该分子相关的全部信息、查看原始分析数据。在排重或与他人共享项目信息时,按结构或化合物类别检索对下游研发同事十分有用。
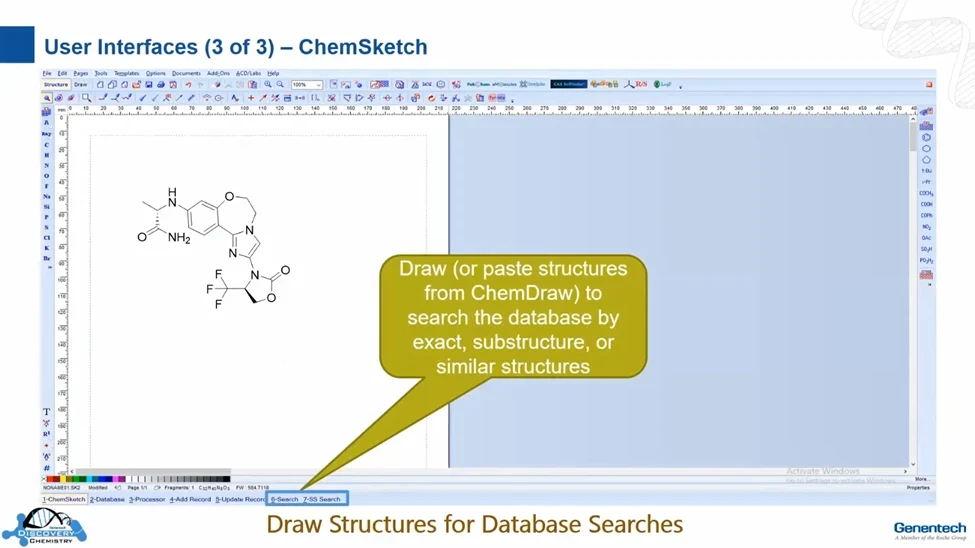 在 ChemSketch 中对指定数据库发起结构/子结构检索
06 纯度判定:多检测器交叉印证
Genentech 对不同纯度的化合物设有不同标准,以决定其是否可注册、能否进入生物活性测试或动物实验,因此查阅化合物纯度表与相关报告非常重要,并可查看以 PDF 格式存储的各类分析技术报告,必要时回溯原始数据进行再处理。
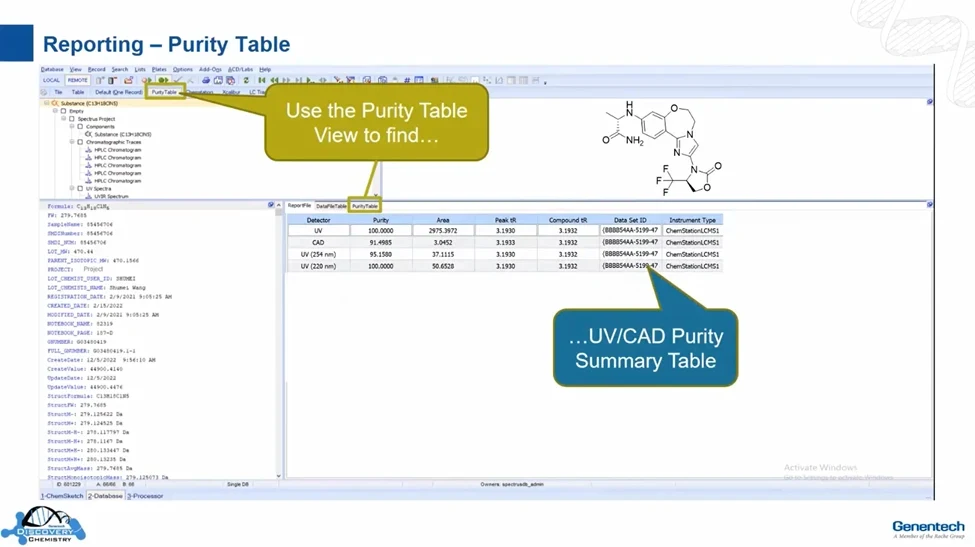 该样品在 UV 下显示纯度 100%,但在 CAD 通道下发现数个杂质;不同紫外波长(254 nm 与 220 nm)也给出不同纯度值,便于识别纯度风险
07 结构验证:让数据来打分
通常情况下化学家合成的目标结构是正确的,但仍存在例外。使用定制的结构验证脚本,可根据化学家给出的确定片段生成若干同分异构体,对全部候选结构基于谱学实验结果逐一评分,以此判断是否存在更贴合实验数据的潜在结构。
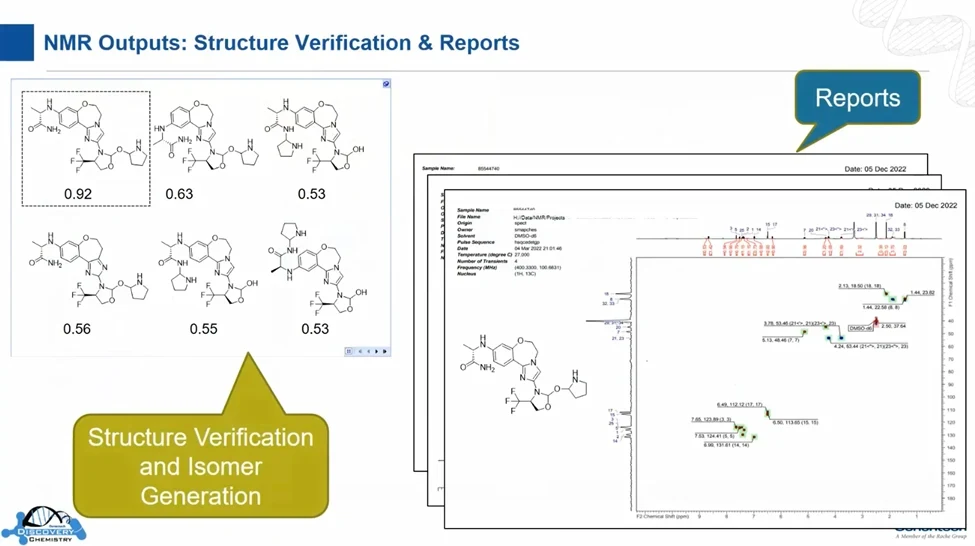 上图示例中目标结构得分最高,右侧为对应的验证报告;当多个结构评分接近时,通常需要补充 HMBC 等额外实验以明确结论
08 MS/MS 镜像比对与 Markush 归属
下图是一份 LC-MS/MS 报告,包含组分纯度表、全部色谱图,以及在六种不同碰撞能量下采集的 MS/MS 数据——高碰撞能量可提供更丰富的结构信息,这些均作为相关知识保存入库。
下游科研人员可用 MS/MS 数据检索该数据库,并以镜像方式显示结果:上方为待检索谱图,下方为库中命中谱图。通过比对差异,即可判断化合物结构发生变化的位置。
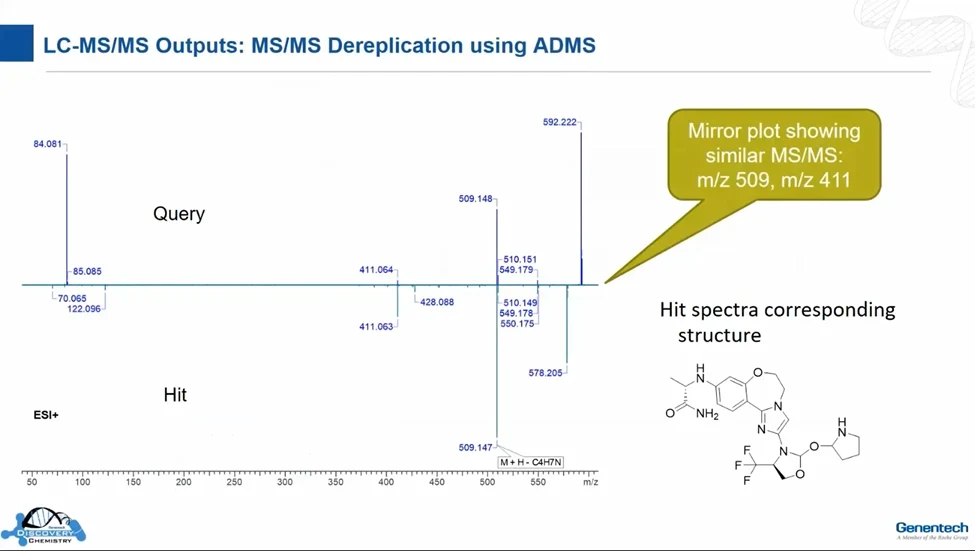 MS/MS 谱图的镜像比对:上为查询谱图,下为数据库命中谱图
在本案例中,经谱图比对可判断该化合物的某个环上多了一个甲基,且这一甲基应位于图中标示的五元环上。此时可在数据库中使用 Markush 结构进行结构归属:对 DMPK 部门而言,用 Markush 结构表述完全可接受,而不必过度归属成某个确定结构。
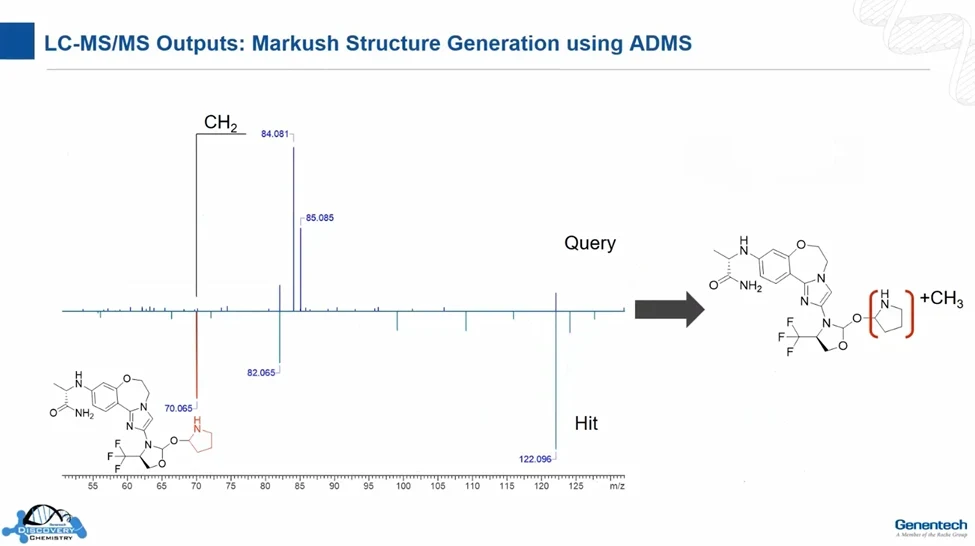 使用 Markush 结构将甲基定位在含氮五元环上,避免强行指定到某一确定位点
09 报告输出与预测库自学习
Genentech 科研人员最认可的关联报告的功能之一是:能够按所需格式与内容生成分析报告,以满足专利申请与论文发表的要求。
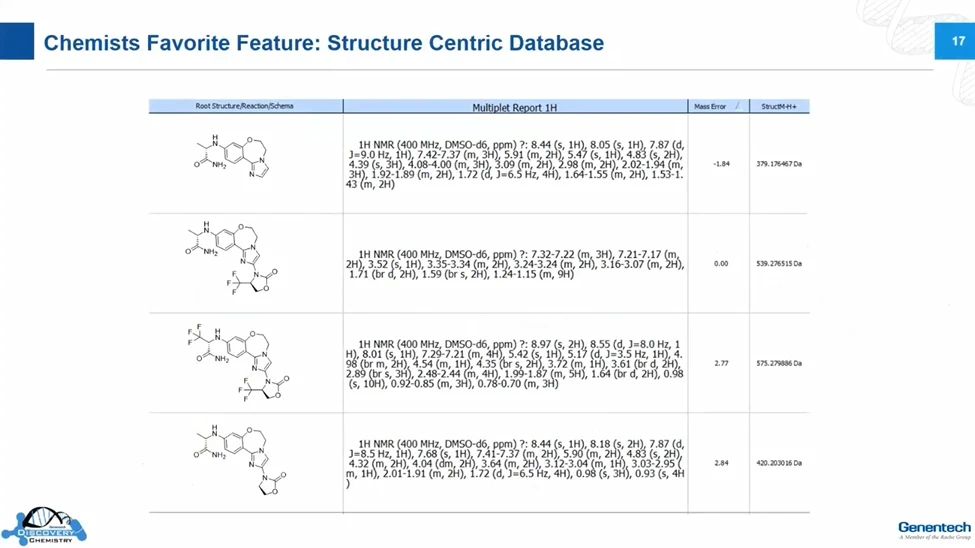 按需定制格式的分析报告,直接服务于专利与论文撰写
Genentech 也非常重视 ACD 在化学位移预测方面的价值。尽管预测仍存在一定误差,但经验表明:一旦将某一类化合物中的一个成员加入预测数据库,系统在预测同类别其他化合物时表现会明显更好。以下图甲基化结构为例,ACD 原先的预测值与实验值存在差异,但在把同类化合物 G′0068 加入预测库之后,对左侧甲基化合物的预测结果几乎完全准确。
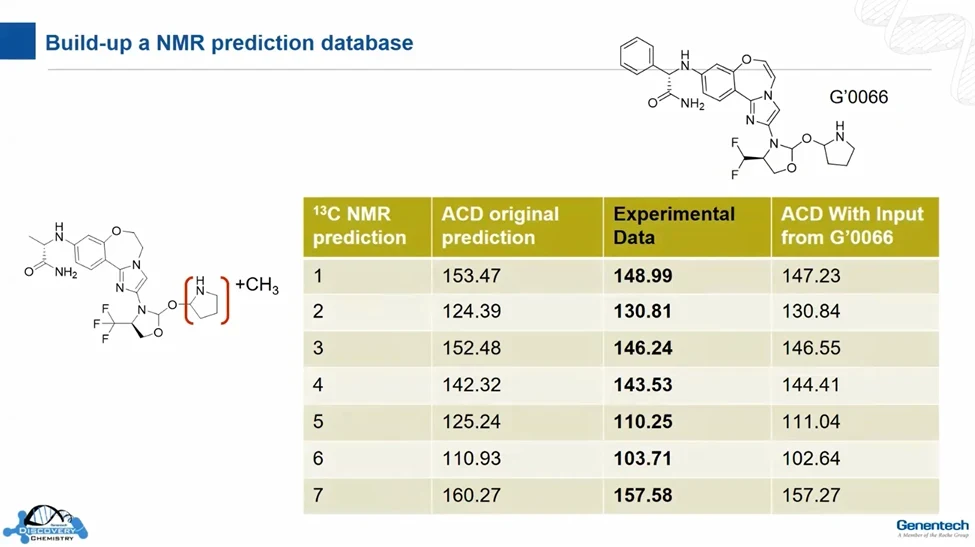 预测值与实验值对比:加入同系物后,该类化合物的预测准确度显著提升
解析注释后的数据是预测数据库的宝贵资源,对所有部门都有价值。所有合成化合物均采集 6 个碰撞能量下的 LC-MS/MS 数据;NMR 部分统一采用 NUS 采样采集 1H、COSY 与 HSQC 谱图,每个化合物采集时间约 15 分钟。谱图采集与数据自动处理分析均在夜间完成,包括自动执行谱图验证,以找出与实验数据最匹配的化合物结构。
目前仅有两种情形需要人工审核:一是自动验证时软件发现存在更优结构;二是对内部谱图预测数据库进行机器学习训练时。
10 总结与展望
Genentech 的愿景是:无论项目的新老成员,都能通过简单易用的界面方便地获取所需数据,回答研发中的问题,从而大幅缩短结构解析的时间;同时在项目由早期发现阶段转入后期开发阶段时,项目中的全部杂质信息与特性信息能随项目一并移交,使接手的人能够继承早期阶段积累的知识。
在 MS-MS 方向,市面上虽有不少自动解析程序,但部分算法给出的分子离子峰与碎片离子峰结果并不完全可靠。为此 Genentech 正与 ACD/Labs 合作:收集经 NMR 确认结构的化合物在六个不同碰撞能量下的 MS-MS 谱图,供机器学习算法学习,以期提升未来新化合物 MS-MS 谱图的解析准确度。
产品说明
文中提及数据库的数据库端产品为 Spectrus Enterprise DB;其只读客户端为 Spectrus Processor,读写客户端为各类 Workbook,相关能力现已演进至基于 Web 的 Spectrus JS 平台。文中原有的自动化平台为 Automation Server,新一代低代码自动化平台为 Spectrus Conduit。
参考资料
- Sarah J. Robinson(Genentech)在 ACD/Labs Virtual Symposium 上的报告《Driving Efficiency with Spectrus®》。
- 微信公众号「凯美科」相关文章。