4.26 Peptidolipin B
海洋来源的放线菌已成为具有治疗价值的次级代谢产物的丰富来源。尽管海洋诺卡氏菌(Nocardia spp.)的研究不如其他海洋放线菌广泛,但它们也是抗菌化合物的重要来源。在陆生诺卡氏菌分离物中,脂肽类化合物Peptidolipin NA 是其中一种抗菌物质。Peptidolipin NA属于一类罕见的环化脂肽,其肽链通过酯键与疏水性脂质尾相连,形成独特的环状结构,这一特征在天然产物中较为罕见。
Wyche 等[29]从海洋诺卡氏菌中分离出五种新型脂肽,命名为Peptidolipins B–F。这些脂肽被认为与Peptidolipin NA 的L-Val(6)类似物结构相似,每种肽均包含一条脂质链。其中,Peptidolipin B(4.51)因其复杂的结构,被选为StrucEluc 软件结构解析能力的测试对象。
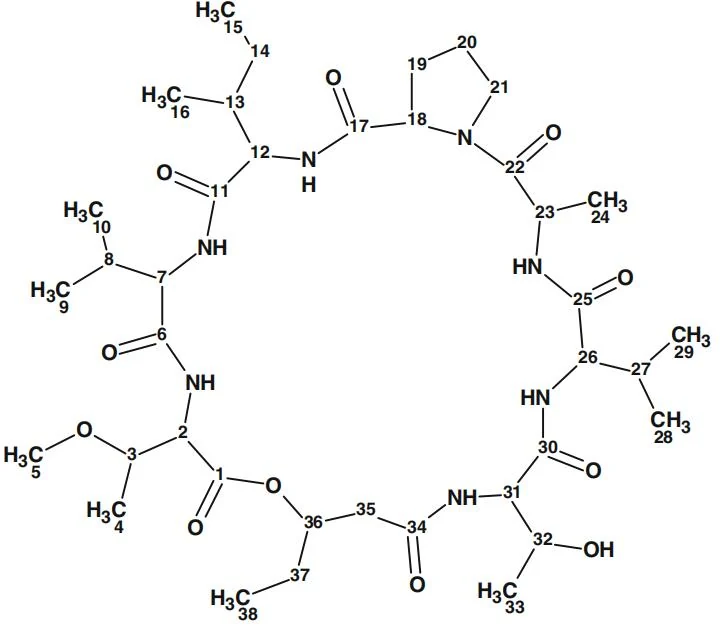
通过高分辨电子轰击质谱(HREIMS)分析,Peptidolipin B 的分子式确定为C₅₉H₁₀₇N₇O₁₁([M+H]⁺ m/z 1090.8087,理论计算值1090.8101)。红外光谱中1742 cm⁻¹处的特征吸收峰为酯基的存在提供了直接证据,而紫外光谱中213 nm 的最大吸收波长则表明分子中缺乏共轭双键系统。作者[29]在¹H NMR 谱的1.2–1.4 ppm 区间观察到18 个CH₂基团的特征信号,这些信号归属于分子中的脂质链部分。为简化结构解析过程并避免程序自动生成冗长的脂质链结构,在Peptidolipin B 的简化结构(4.51)中,脂质链被异丙基(原子8–10)取代,分子式相应简化为C₃₈H₆₅N₇O₁₁。
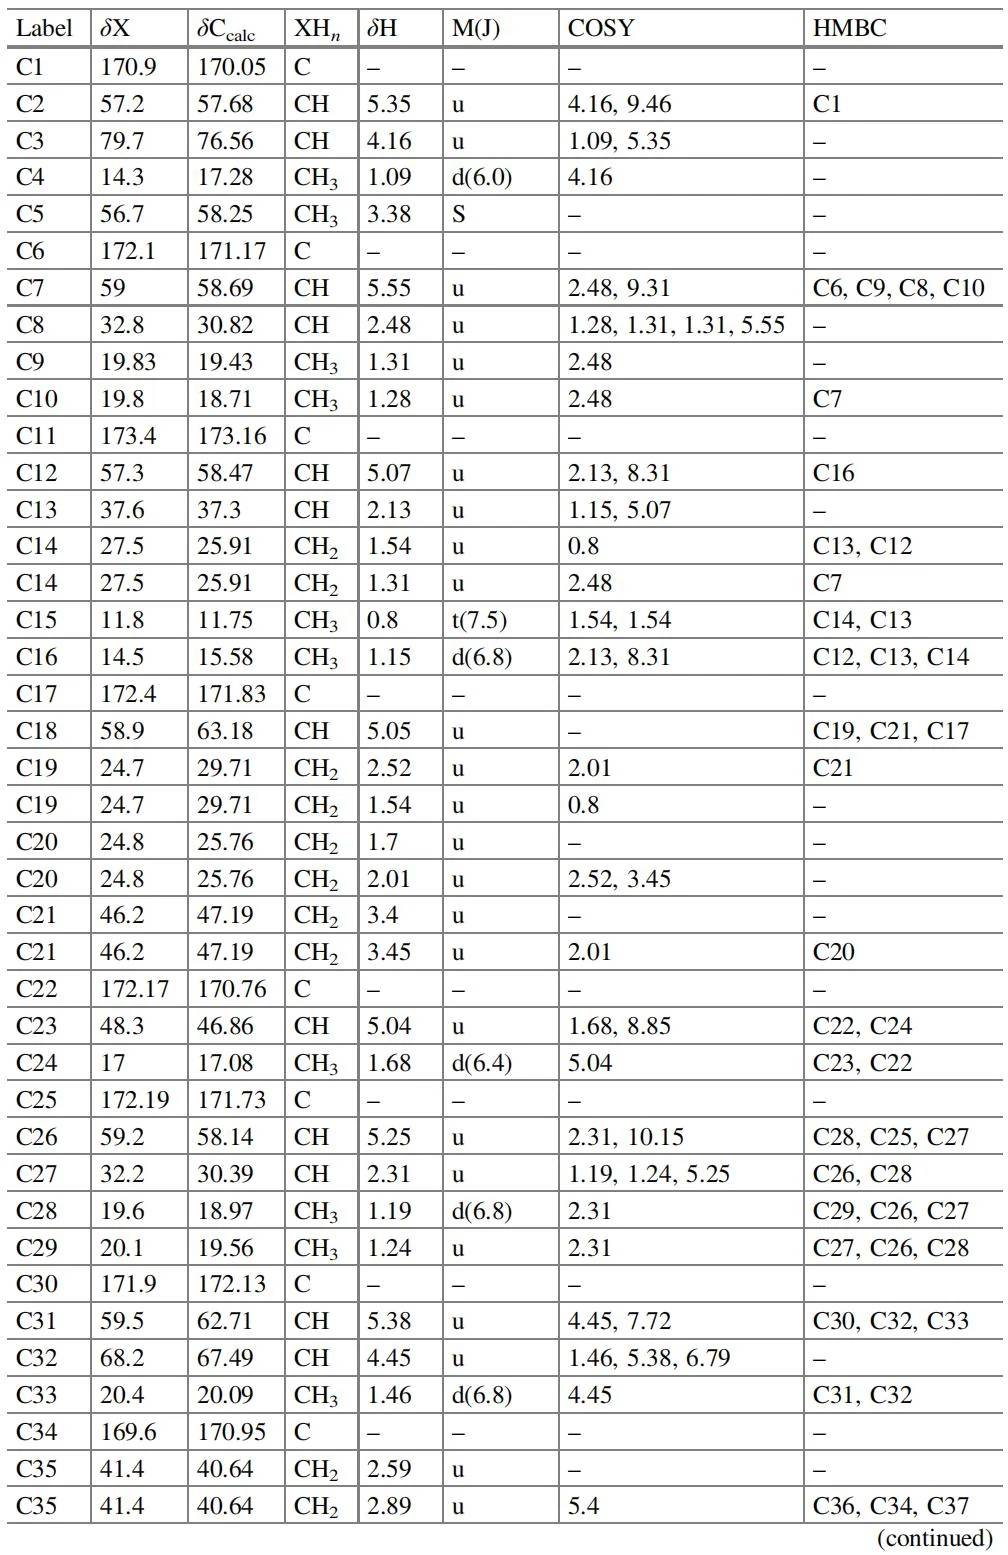
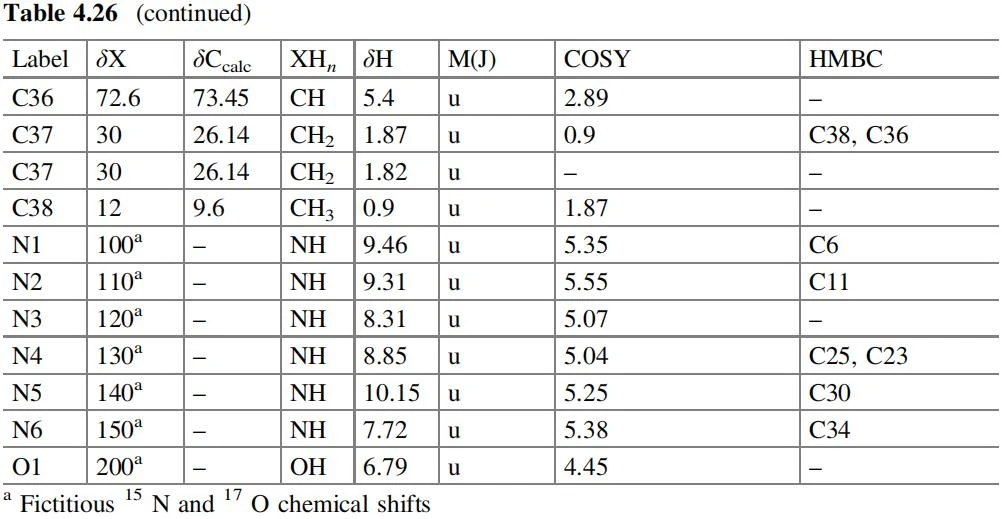
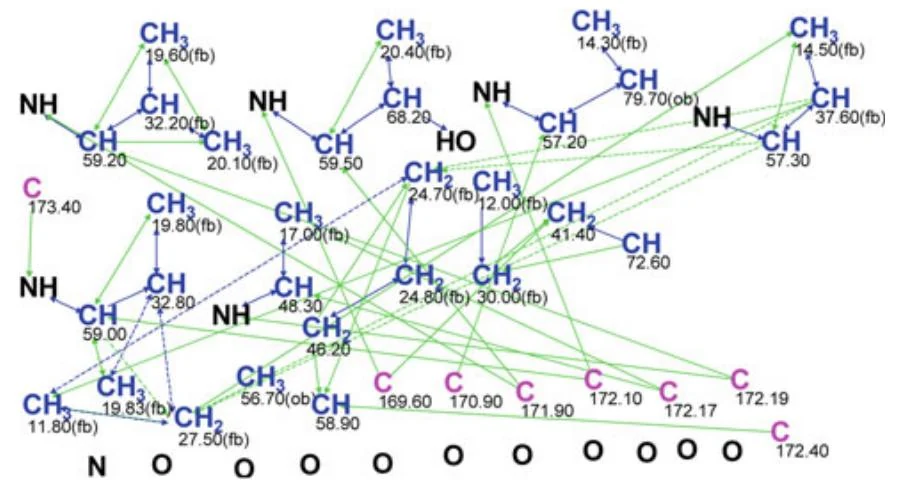
用于计算机辅助结构解析的NMR 数据汇总于表4.26 中,基于这些数据构建的分子连接图(MCD)如图4.63 所示。数据包括从二维NMR 谱中提取的46 个COSY 相关信号和51个HMBC 相关信号,为后续结构解析提供了关键信息。
MCD 概述:
尽管分子连接性信息较为丰富,但由于分子中杂原子数量众多(总计18 个,包括7 个氮原子和11 个氧原子),在结构生成过程中碳-杂原子组合的可能性显著增加。例如,基于已知的谱图-结构相关性,所有¹³C 化学位移位于169–173 ppm 区间的碳原子均可能通过双键与氧或氮原子相连。结合该化合物为肽类分子的先验知识,可以将所有相关碳原子的双键连接限定为氧原子。此外,对于化学位移位于46.2–173.4 ppm 区间的碳原子,根据其特征性¹³C和¹H NMR 化学位移值(见表4.26 中相应的δH 值),为其分配“ob”属性,以进一步明确其化学环境。基于上述分析,对MCD 进行了优化,优化后的MCD 如图4.64 所示。
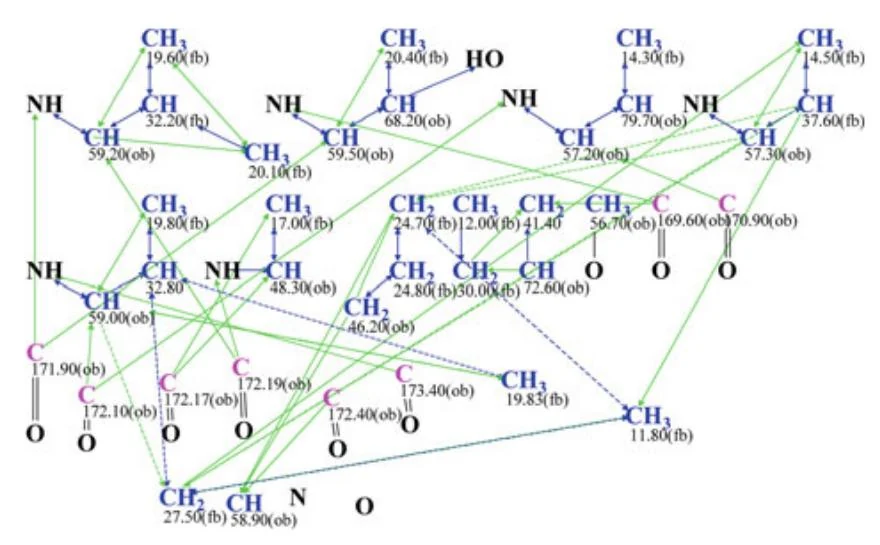
MCD 检查结果表明所有二维NMR 数据均一致,随后启动了严格结构生成及¹³C 化学位移预测。结果显示:k = 5,117 →482 →458,tg = 20 s。输出文件中排名靠前的结构如图4.65所示。
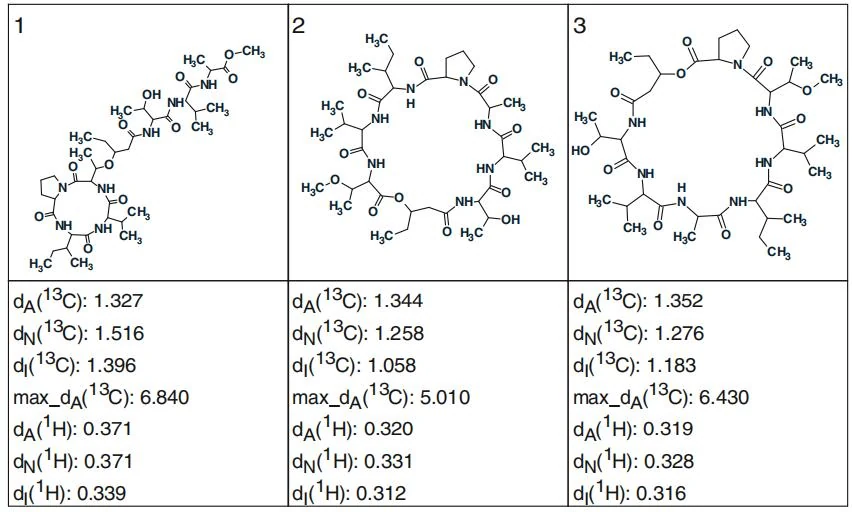
通过HOSE算法预测选择的最优结构#1与Peptidolipin B的简化模型结构4.51存在差异,而结构#2 则与之完全一致。尽管两种结构的dA 偏差值相近,但基于其他方法计算的¹³C 和¹H化学位移平均偏差,结构#2 的优先级更为显著。所有排名靠前的结构均高度相似,且第一与后续结构之间的偏差差异较小。因此,需对结构#2 进行进一步验证。下方展示了Peptidolipin B 的简化模型结构(4.52)及其¹³C 化学位移归属,为结构确证提供了直接实验依据。
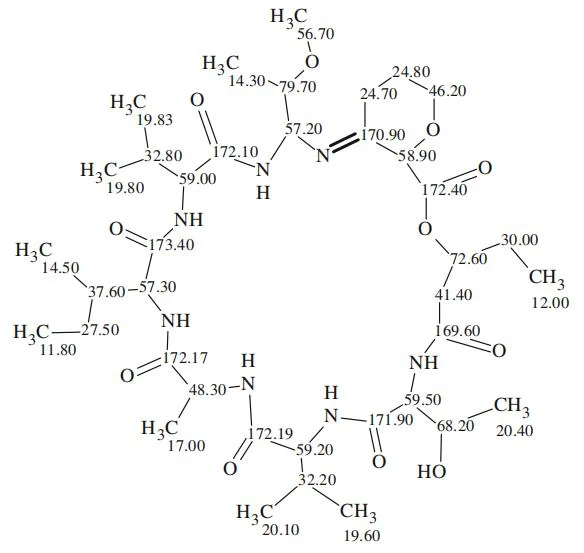
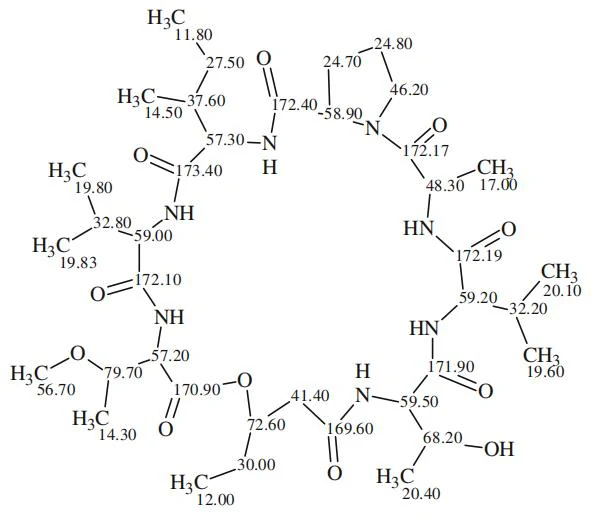
4.52 4.53为辅助解决这一结构解析问题,我们引入了一系列合理的假设条件(“axioms”)。其中,我们假定所有sp²杂化的碳原子均以羰基形式存在。为进一步验证这一假设的科学性,我们删除了手动绘制的C=O 双键,并允许程序生成含C=N 键的结构。在此条件下,计算结果显示:k = 226,121 →616 →592,tg = 14 小时3 分钟。值得注意的是,标准程序仍能准确识别出相同的最优结构(见图4.65)。移除上述约束条件后,不仅计算结果发生显著变化,计算时间也大幅增加:初始生成的结构数量增加了40 倍,而计算时间(tg)更是激增1,500 倍。最终输出文件的大小差异为85 个结构(592 vs. 507),这些额外结构均包含一个C=N 键。其中,“最优”的C=N 结构(4.53)与正确结构(4.52,C=N 键以粗体标记)进行了对比分析。尽管结构4.53 的化学位移偏差约为2.5 ppm,表面看似合理,但其在排序文件中仅位列第262位,因此被程序自动排除。
这一典型案例充分证明,当目标化合物明确归属于肽类时,在MCD 中手动绘制羰基双键可显著提升问题求解效率。这一策略不仅有效减少了计算时间,还显著提高了结构解析的准确性,为复杂天然产物的波谱解析提供了重要的方法学启示。