外排转运体 P-gp 预测模块
外排转运体(efflux transporter)属于ABC家族,能够促进化合物从胞内排除。p-糖蛋白(P-glycoprotein,P-gp)是药物发现中最为熟知的外排转运体,可从多种细胞中排出化合物。其功能与药物的吸收、分布、排泄、中枢神经系统作用、多药耐药(MDR)有关。
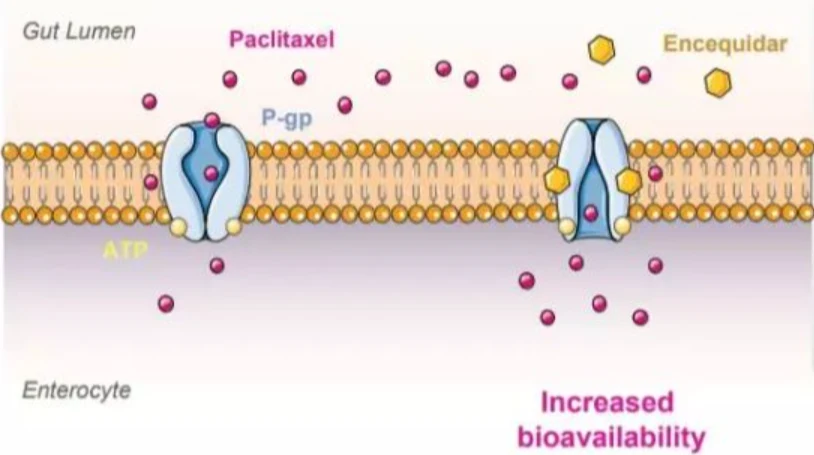
P-gp被认为是肿瘤细胞对多种药物(如紫杉醇paclitaxel、依托泊苷etoposide)产生耐药性的主要原因。经过化疗后,许多肿瘤细胞被杀死,但仍有一部分肿瘤细胞存活下来并继续生长。研究发现,肿瘤细胞能够表达P-gp和其他外排转运体,这些转运体可将抗肿瘤药物从肿瘤细胞内排出,起到了保护作用,使肿瘤细胞得以存活。
Percepta 软件的P-gp特异性预测模块可以快速识别候选药物是否为P-gp底物或抑制剂。从巨大的“内部”合成化合物或虚拟化合物库中过滤和排除P-gp潜在的底物/抑制剂是可能的。P-gp特异性预测模型可以作为一种初步筛选方法,替代基于P-gp ATP酶活性测定的筛选试验,并部分替代P-gp表达的细胞膜体外实验和P-gp基因敲除动物的昂贵体内实验。
另外,用户可通过实验室“内部”的实验数据对P-gp特异性预测模型进行再训练,进一步提升模型预测的可靠性。
功能特色:
P-gp预测模块使用两个模型来估计化合物作为P-gp底物\抑制剂的概率:1-该化合物是否为P-gp的抑制剂/底物?2-如果是,它是一种较强的抑制剂/底物吗?
另一种基于知识的模型可根据化合物的结构特征和基本理化参数将其分为P-gp抑制剂和非抑制剂;
统计算法通过可靠性指标计算的方法来评估计每一个预测结果的可靠性;
显示后台数据库中5个最相似化合物的实验数据;
训练集包含超过1500个化合物实验数据,参考数据来自800多份原始出版物;
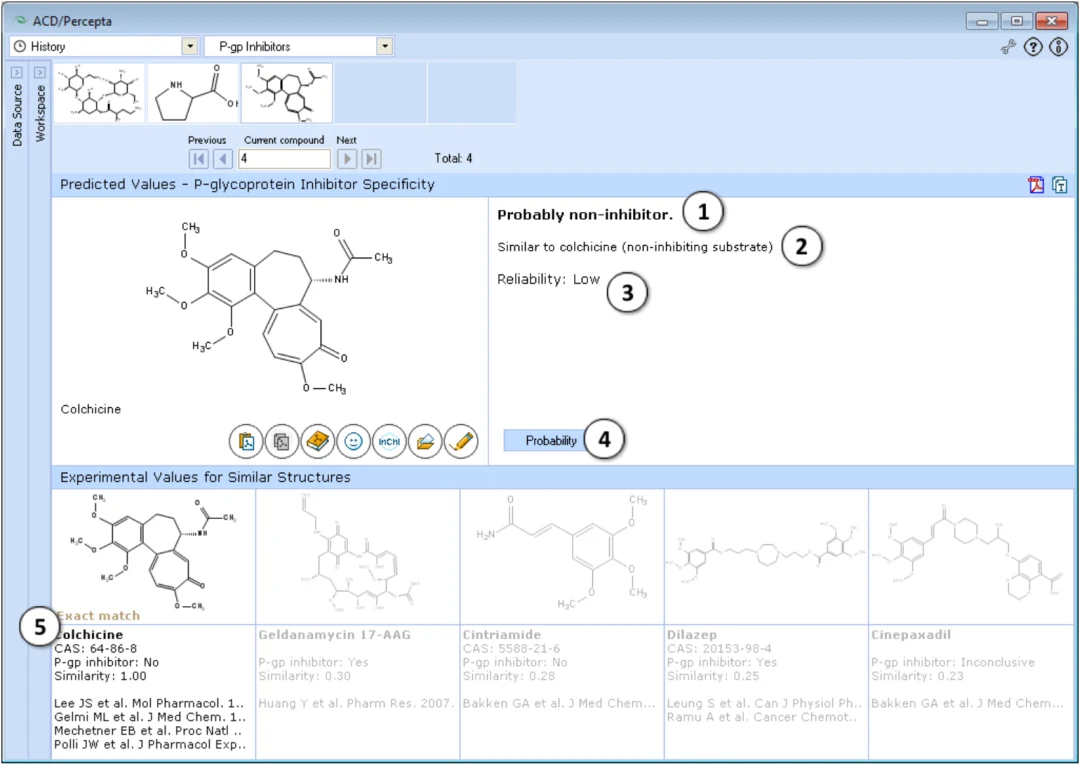
P-gp底物预测界面
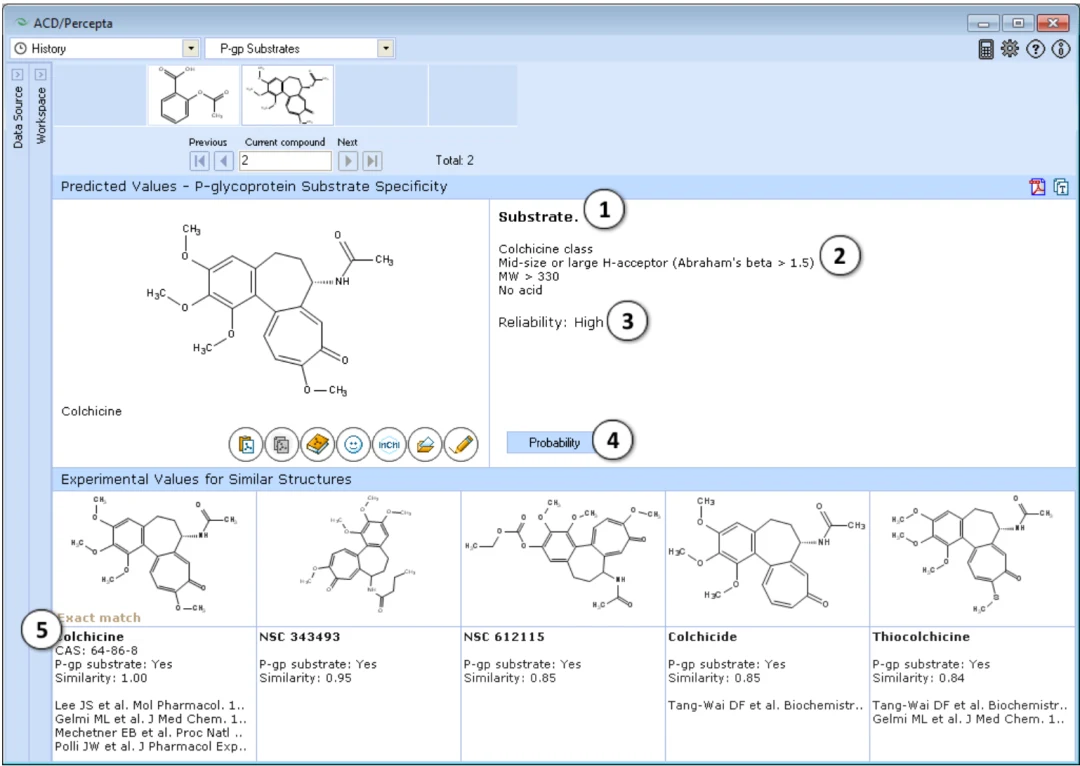
查看P-gp数据库中5个最相似的化合物结构,并附上相应的实验结果和参考文献
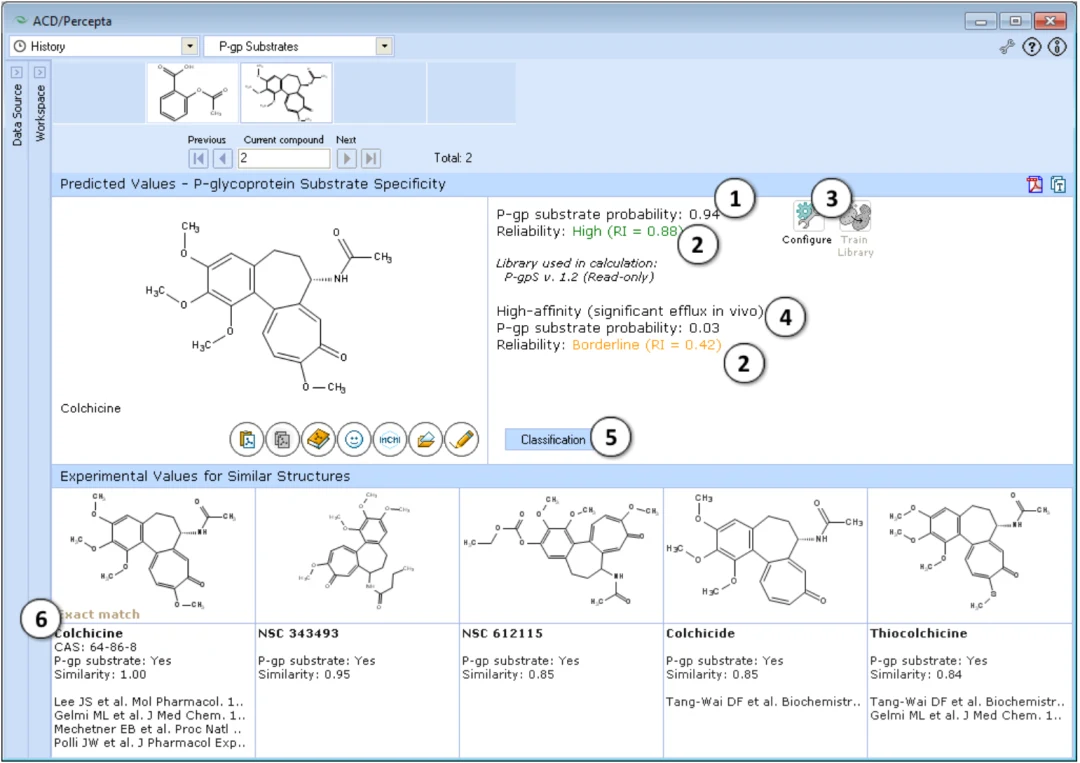
用户可通过“配置”和“训练”按钮选择用于计算的训练集和向训练集中添加新的实验数据。当前所选库的名称用斜体表示。
该化合物为高亲和力的P-gp底物并在体内表现出显著外排的可能性
切换到基于知识的分类模型
查看P-gp模型后台数据库中5个最相似的结构,并附上相应的实验结果和参考文献
P-gp抑制剂预测界面
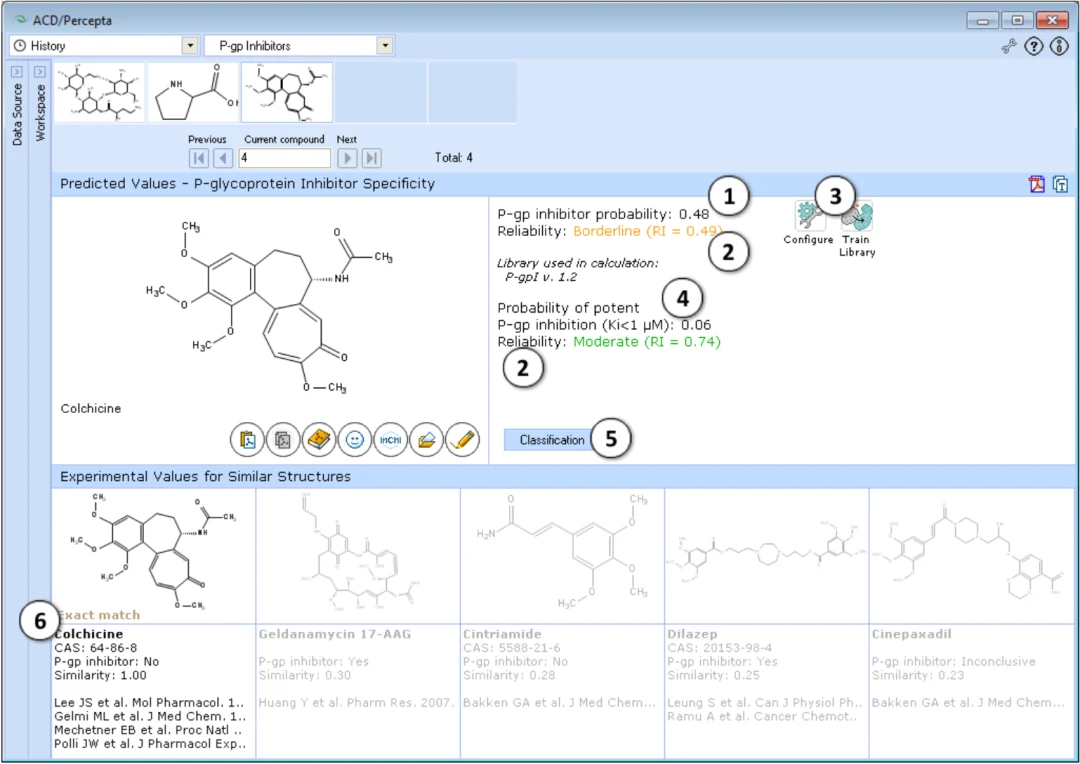
用户可通过“配置”和“训练”按钮选择用于计算的训练集和向训练集中添加新的实验数据。当前所选库的名称用斜体表示。
- 化合物为P-gp潜在抑制剂(Ki < 1 uM)的可能性
- 切换到基于知识的分类预测模型
- 查看P-gp模型后台数据库最相似的结构及实验结果、参考文献
- 注: 根据可靠性指数(RI)值划分预测可靠性的等级:
- RI < 0.3——不可靠,
- RI范围在0.3~0.5——临界可靠,
- RI范围0.5~0.75——中等可靠,
RI >= 0.75——高度可靠。
关于模型的技术介绍
实验数据
在P-gp特异性研究中,人们使用了许多体外和体内试验数据,但往往产生相互矛盾的结果。Percepta软件中的P-gp特异性预测模型从科学文献中严格谨慎地收集相关数据。
01 针对P-gp底物的数据,主要考虑以下测试数据:
P-gp表达的细胞单层膜极化转运体外试验
P-gp基因敲除的动物体内BBB模型中,P-gp介导的耐药试验
02 针对P-gp抑制的数据,主要考虑以下测试数据:
P-gp表达的细胞药物外排抑制试验
MDR逆转试验
P-gp底物的数据集包含>1000个化合物,抑制剂数据集为>1500个化合物。
数据库
在Percepta软件中,提供了一个可浏览、查询的P-gp数据库,由2290个化合物组成,实验数据与P-gp的相互作用有关。数据库中的每一种化合物都被归类为P-gp底物或非底物(不确定或矛盾的数据在“底物”字段中标记为Yes/No或No/Yes),并按照强度对P-gp底物进行了分类。标注为High efficiency的化合物指的是化合物作为P-gp底物的强度与最佳底物(长春碱,柔红霉素,紫杉醇)相似。类似地,组成P-gp抑制的数据库也对化合物进行了相应的分类。Potency表示化合物对P-gp抑制强度,High potency代表化合物抑制P-gp的效果与标准抑制剂维拉帕米一样好,甚至更好。
在Assays部分,列出了用于P-gp底物/抑制剂特异性分析的方法:
Substrate (in vitro transport assay) – -药物通过表达P-gp的细胞单层极化运输或在MDR细胞中的减少药物积累减少
Substrate (in vivo BBB models) - 在P-gp基因缺乏(mdr1a/b(-/-))的小鼠中药物向大脑的分布增加
P-gp mediated resistance- P-gp过表达(MDR)细胞中表现出对该药耐药
Drug efflux inhibition- P-gp表达细胞中的药物外排被抑制
MDR reversion - P-gp表达的细胞对“多药耐药谱”药物(紫杉类、蒽环类、长春碱)的敏感性
P-gp ATPase modulation -P-gp ATP酶的激活或抑制。本实验不区分P-gp底物和抑制剂。
模型特征和预测精度
P-gp抑制的预测模型采用GALAS [1](Global, Adjusted Locally According to Similarity)建模方法进行搭建。
03 每个GALAS模型由两部分组成:
采用二项偏最小二乘法的全局基线统计模型,使用一组预定义的片段描述符进行多次自举进行训练,这模型反映了P-gp抑制特异性的一般趋势。
基于相似性的分析,考虑到训练集中最相似化合物的基线值和实验值之间的差异,对基线预测进行局部校正。
GALAS方法还提供了评估预测可靠性的基础,通过计算可靠性指数(RI)值,考虑到:
被测试化合物与训练集分子的相似性(如果没有发现类似的化合物,预测是不可靠的);
在训练集中与测试分子相似的化合物的实验LogP值和基线模型预测的一致性(相似分子的存在的实验数据差异较大,会导致较低的RI值)。
可靠性指数RI值范围从0到1(0表示完全不可靠,1表示高度可靠),并用于指示提交的化合物是否属于模型适用范围。RI < 0.3的化合物被认为在模型的适用性范围之外。
基于GALAS方法搭建的预测模型是允许用户对预测模型进行再训练的。用户需要预测的化合物结构所在的化学空间往往超过了软件内置的模型所覆盖的化学空间,这导致大多数的QSAR模型没法对用户“内部”的化合物适用或者受限,通过对模型的再训练,解决了这一问题。Percepta软件的“训练引擎”根据对实验数据库中类似化合物的分析,对基线QSAR模型产生的系统偏差进行适当的修正。使用用户自定义的新化合物实验数据扩展该自训练库,可立即提高各自化合物类的预测精度。此外,“内部”数据的添加允许对现有模型进行调整,以适应贵单位使用的特定实验方案,并避免用于确定药物与P-gp相互作用的不同实验方法之间的差异问题。
本文内容整理自凯美科公众号文章,原文中的推广信息与联系方式已去除。如需了解相关模块与 ADME Suite 的更多信息,欢迎联系我们。