自动化未知物质谱结构定性:Automated MS Structure ID 工作流程
面对复杂样品中数十乃至上百个未知组分,人工逐一解析高分辨质谱数据耗时且难以标准化。本文以一例 LC-HRMS-MS 数据为例,按原文完整演示 Automated MS Structure ID 的四个步骤——导入数据、处理数据(组分化)、基于分子量的数据库检索、保留时间预测过滤,直至逐组分的碎片归属确认。
它解决什么问题
Automated MS Structure ID 是 ACD/Labs 质谱软件 MS Workbook Suite 的一个增强型功能组件,用于对高分辨质谱全扫描数据中的组分进行识别,并将识别出的组分用于结构数据库检索。检索目标既可以是 ACD/Labs 提供的公开数据库(如超过 9000 万化合物的 PubChem),也可以是用户自建的细分领域已知结构库;对天然产物研究的用户,凯美科还提供约 40 万结构的天然产物数据库及各植物科属成分库作为检索对象。
检索命中的同分异构体,会以质谱碎片归属情况进行打分排序,也可附加预测的色谱保留时间进一步过滤。若与 ACD/Labs 的谱图数据库检索流程(IXCR)联合使用,应用面会更广。
工作流程示例
第 1 步 导入数据
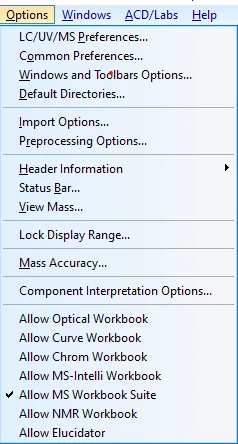
打开 MS Workbook Suite 的工作界面,导入含有 MS1、MS2 的 LC-HRMS-MS 数据。ACD/Labs 软件支持市面上几乎所有高分辨质谱的原始数据类型,这意味着有跨平台分析需求的实验室可以在一个软件上读取包括 AB Sciex、Waters、Agilent、Shimadzu、Bruker 等公司在内的质谱数据。
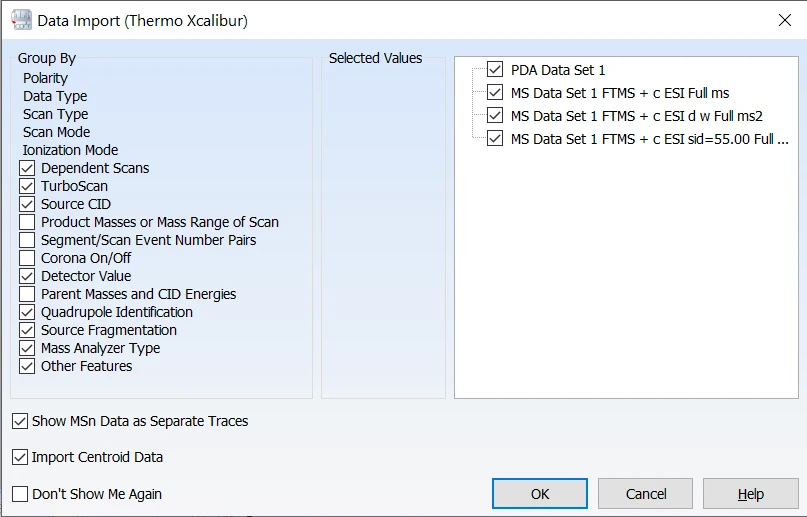
以 Thermo Xcalibur 格式为例,导入时可按极性、数据类型、扫描类型、电离模式等属性分组选择数据,并可将 MSn 数据作为独立谱迹显示、以质心(centroid)方式导入:
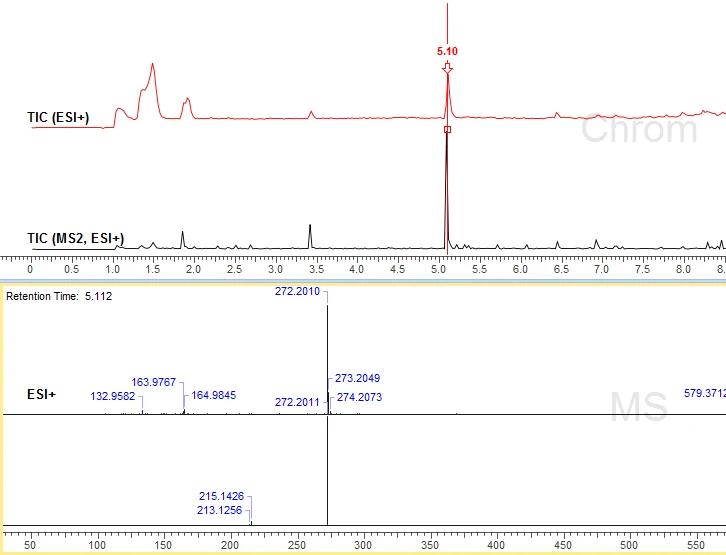
样本数据打开后,窗口中同时显示 TIC(ESI+)总离子流色谱图、TIC(MS2, ESI+)二级色谱图以及所选扫描点的 ESI+ 质谱图:
第 2 步 处理数据(组分化)
选定要处理的对象谱图区域(下图中白色范围):
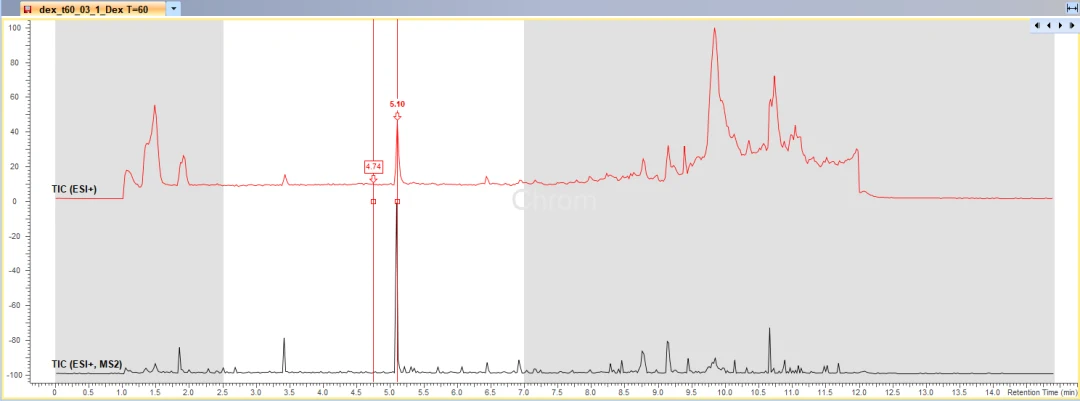
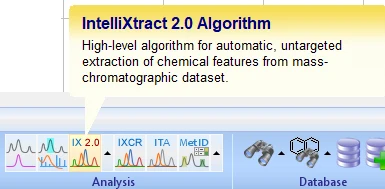
运行组分化工具,提取选定范围内的所有有价值组分——这一步把总离子流图中的共洗脱、痕量组分分离为纯净的单个组分质谱图,为后续检索奠定基础:
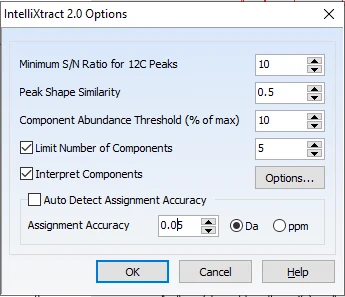
提取组分的数量和多少,可通过 IntelliXtract 参数按需调节(最低信噪比、峰形相似度、组分丰度阈值、组分数上限、归属精度等):
第 3 步 基于分子量的数据库检索
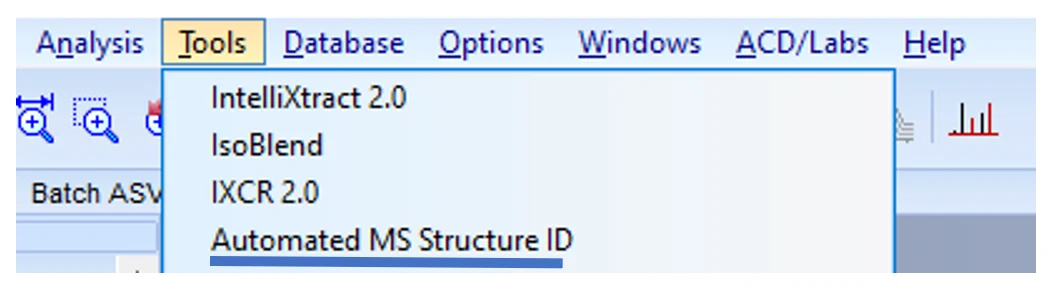
在工具栏打开 Automated MS Structure ID(与 IntelliXtract、IXCR 等工具同位于 Tools 菜单):
在运行对话框中,按实际情况设置组分化参数、分子量窗口宽度、元素组成等:
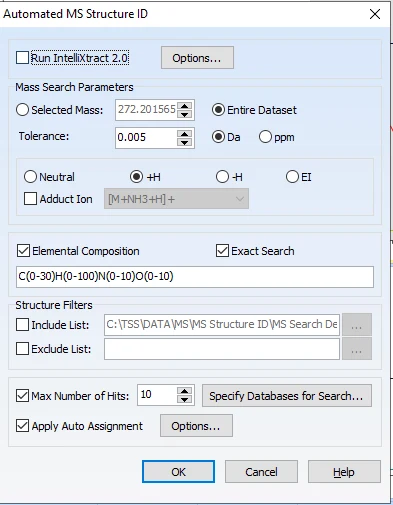
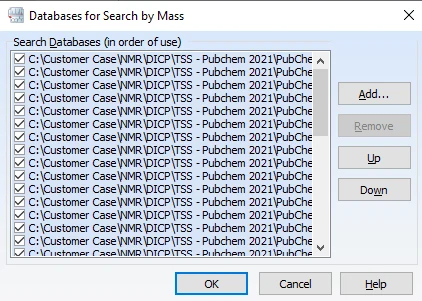
然后确定搜索目标结构数据库的列表。列表可按使用顺序配置多个数据库,并支持添加、移除与排序。用户可根据自己研究的领域选择合适的数据库——对于天然产物研究的用户,可选择凯美科提供的天然产物数据库(包含约 40 万个天然产物结构)以及针对各个植物科属的成分库作为检索对象:
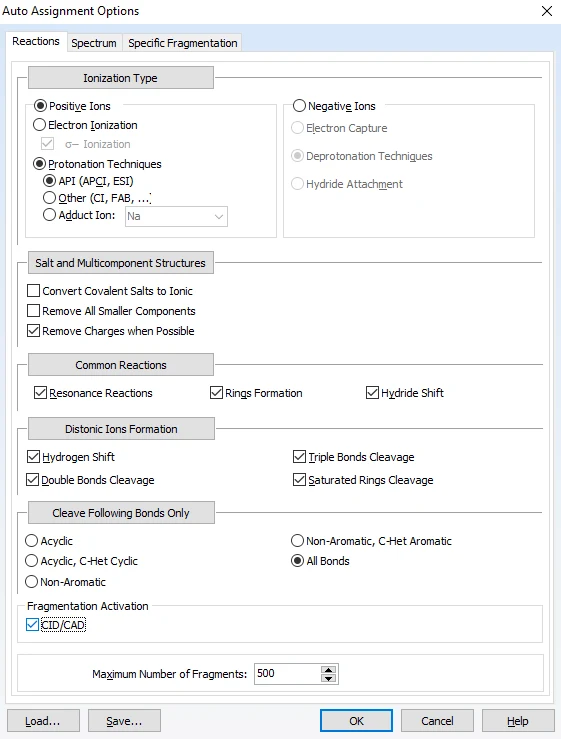
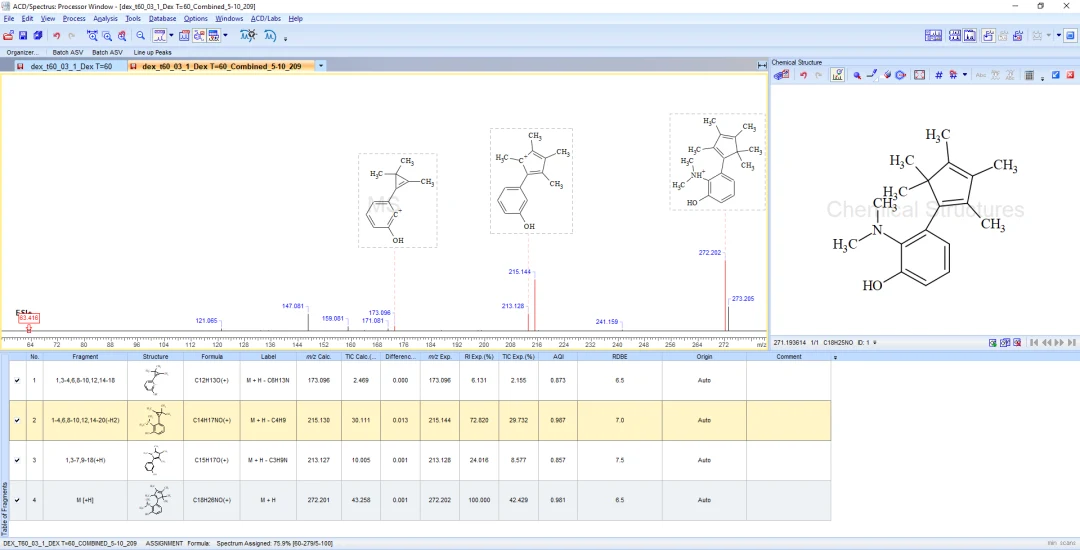
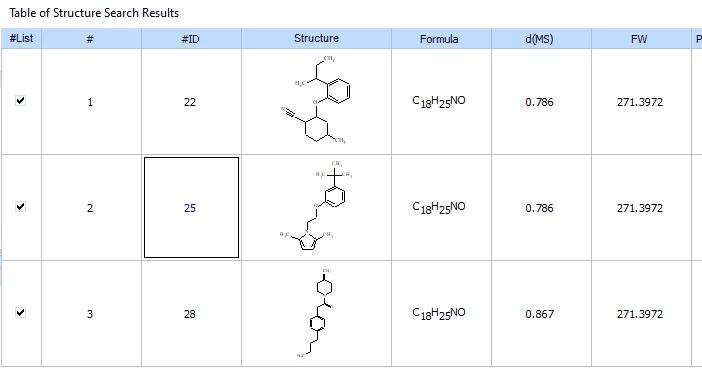
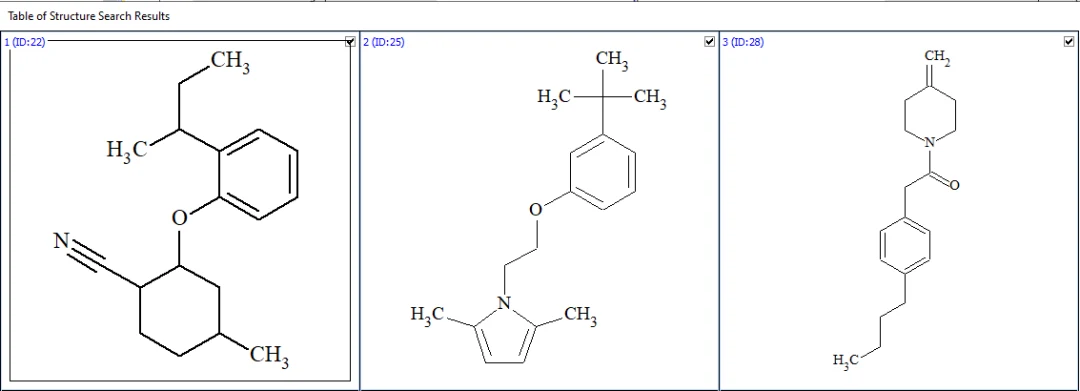
搜索出的同分异构体将进行自动化的碎片归属:基于 MS Fragmenter 的碎片预测分析能力对搜索结果进行排序,并设定保留排序靠前的候选分子数量。约定:质谱碎片归属参数 d(MS) 数值越接近于 1,结构与实测二级谱图的吻合度越高。
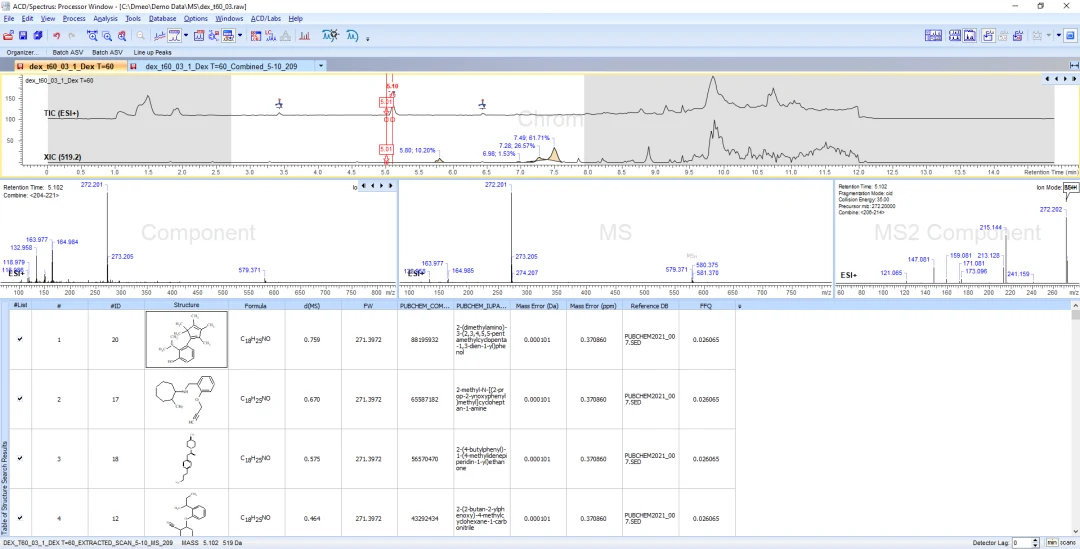
查看每个组分的定性结果时,该组分的候选结构列表会随之显示:
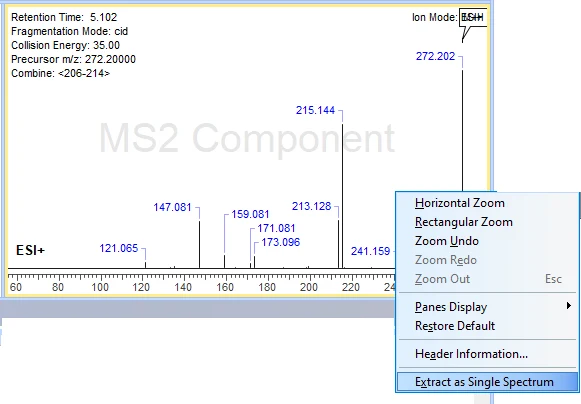
如需人工复核,可将二级质谱手动抽提为单张谱图:
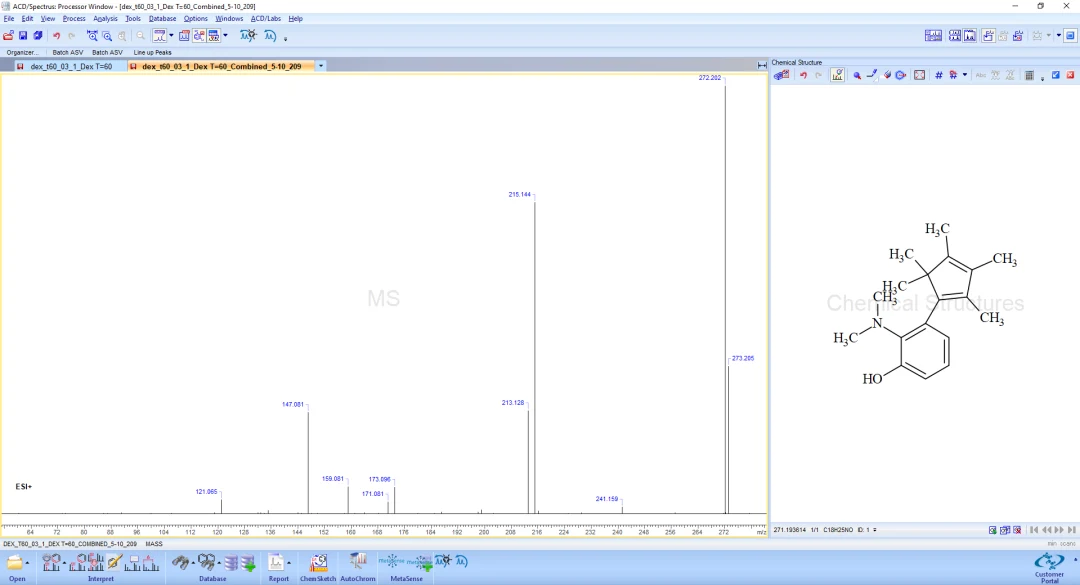
将抽提的二级谱图与目标结构进行自动化归属:
第 4 步(可选) 利用 ChromGenius 预测保留时间减少候选
基于 ChromGenius 的功能,在候选结构列表中即可对候选物的保留时间进行预测计算:
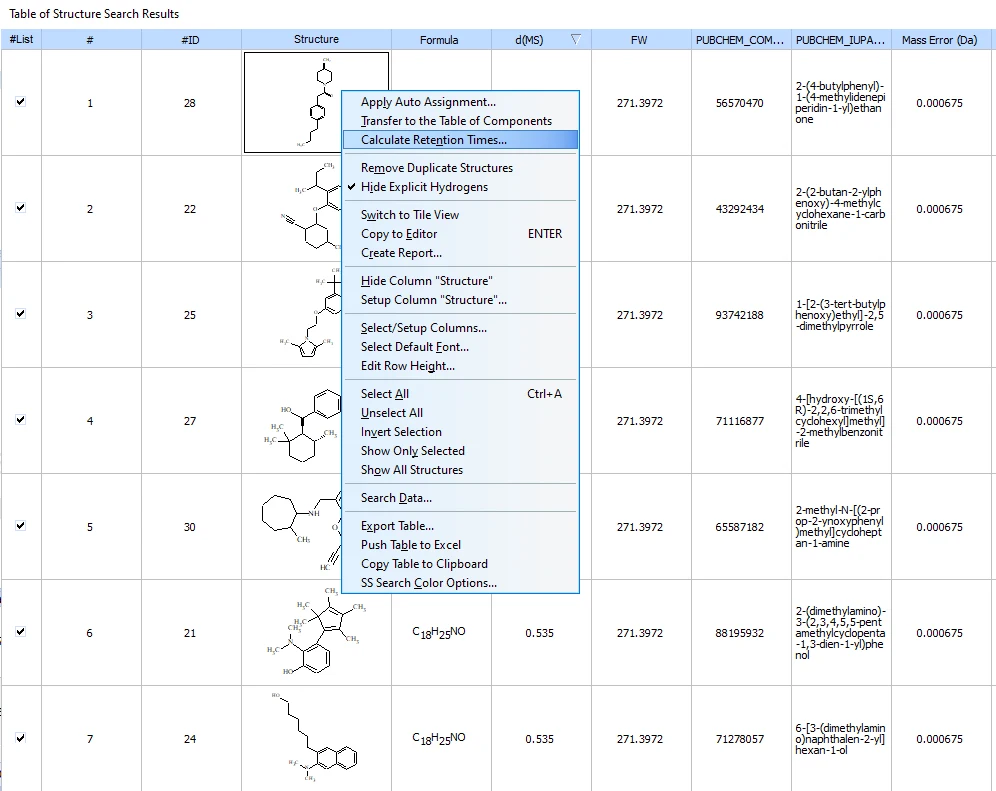
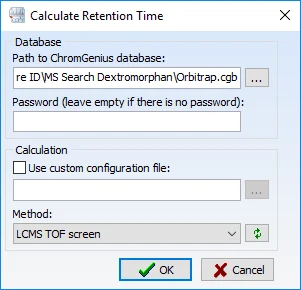
使用 ChromGenius 用户数据库前,需要先在当前液相方法上建立「分子结构—相关理化性质—保留时间」之间的多元线性数学模型,具体建模过程另文介绍。在保留时间计算对话框中指定数据库与计算方法后即可运行:
经过保留时间的过滤后,候选数据量将大幅减少,用户可对筛选后的数据结果进行进一步选择和查看:
小结与适用场景
以上过程完整演示了 Automated MS Structure ID 的典型工作流:它可用于天然产物的高分辨质谱排重、E&L(提取物和浸出物)研究、杂质研究等。对需要高通量、标准化处理大量样品的实验室,这种「导入—组分化—数据库检索—碎片归属验证—保留时间过滤」的一条龙工作流,能显著提升鉴定效率与结果的可重复性。
如需进一步了解产品详情、预约演示或获取方案与报价,欢迎通过联系我们与我们沟通;更多功能与方案介绍可阅读《基于质谱的快速组分识别解决方案》。
本文整理自凯美科公众号文章,配图取自原文。原文中的二维码、联系方式与推广信息已按站内统一规范移除。